
Trong suốt nhiều năm, cuộc đua phát triển Trí tuệ Nhân tạo luôn gắn liền với nghịch lý: mô hình càng thông minh thì hóa đơn hạ tầng càng khổng lồ, khiến các doanh nghiệp bị cuốn vào vòng xoáy phụ thuộc vào các cụm GPU đắt đỏ và khan hiếm. Bước sang năm 2026, sự trưởng thành vượt bậc của kiến trúc 1-bit LLMs — dẫn đầu bởi BitNet b1.58 — đã chính thức mở ra một kỷ nguyên mới: thay thế các phép nhân ma trận dấu phẩy động nặng nề bằng phép cộng số nguyên đơn giản, đưa mô hình ngôn ngữ lớn chạy trực tiếp trên các chip CPU tiêu chuẩn với hiệu năng vượt trội và chi phí vận hành giảm tới hơn 80%.
Giải Mã Cơn Địa Chấn BitNet b1.58: Phép Tính Tam Phân Đảo Lộn Vật Lý Tính Toán
Kể từ khi kiến trúc Transformer thống trị thế giới AI, các mô hình ngôn ngữ đều hoạt động dựa trên độ chính xác 16-bit (FP16 hoặc BF16), đòi hỏi hàng tỷ phép nhân ma trận (Matrix Multiplication - MatMul) tiêu tốn năng lượng khủng khiếp mỗi giây. Ngay cả các kỹ thuật lượng tử hóa (Quantization) phổ biến như INT8 hay INT4 trước đây cũng chỉ là giải pháp nén sau đào tạo (post-training compression) và vẫn phụ thuộc vào năng lực xử lý dấu phẩy động của GPU.
BitNet b1.58 phá vỡ hoàn toàn giới hạn này bằng cách huấn luyện mô hình nguyên bản (Native Training) với hệ trọng số tam phân (Ternary Weights) chỉ gồm ba giá trị duy nhất: {-1, 0, 1}.
- Chuyển đổi cốt lõi từ Nhân sang Cộng: Khi trọng số chỉ là -1, 0 hoặc +1, phép tính ma trận không còn cần phép nhân (Multiplication). Hệ thống chỉ đơn thuần thực hiện phép cộng và trừ số nguyên (Addition & Subtraction), vốn là những phép tính bản năng nhanh nhất và tốn ít điện nhất trên mọi kiến trúc vi xử lý.
- Nén bộ nhớ đột phá đến 32 lần: Mỗi tham số chỉ cần $1.58$ bit (xấp xỉ $\log_2 3$ bit) để lưu trữ thay vì 16 bit, cho phép nén toàn bộ mô hình 7B hoặc 13B tham số xuống dung lượng chỉ vài Gigabyte, nằm gọn trong RAM của máy tính xách tay hoặc máy chủ văn phòng thông thường.
- Cắt giảm 70% - 82% mức tiêu thụ năng lượng: Loại bỏ các bóng bán dẫn xử lý số thực giúp giảm tải nhiệt lượng tỏa ra và điện năng tiêu thụ, biến giấc mơ triển khai AI xanh (Green AI) thành hiện thực cụ thể tại các trung tâm dữ liệu.
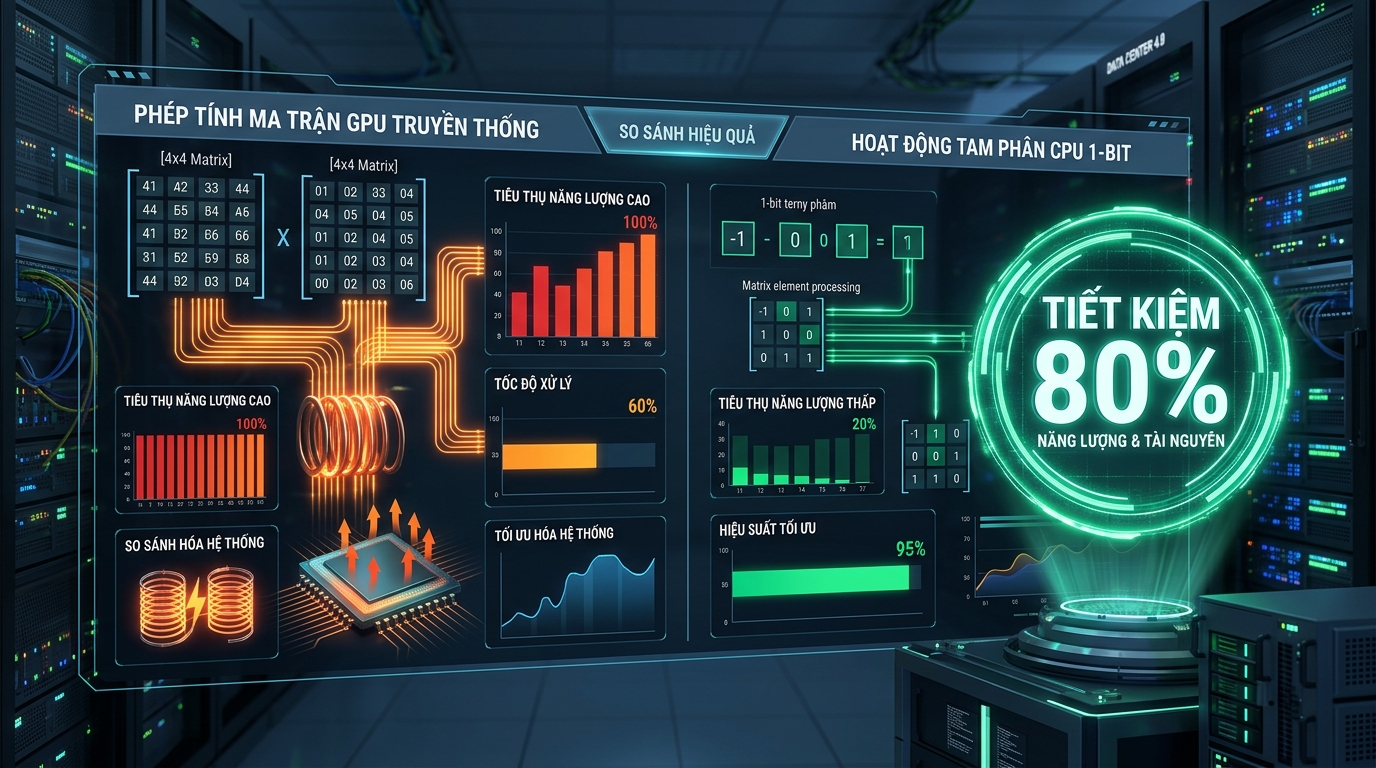
Sơ đồ so sánh: Phép tính ma trận GPU truyền thống so với xử lý tam phân 1-bit trên CPU giúp tiết kiệm hơn 80% năng lượng và tài nguyên tính toán.
Tác Động Chiến Lược Đến Doanh Nghiệp: Xóa Bỏ 'Bức Tường Độc Quyền GPU'
Sự chuyển dịch sang kiến trúc 1-bit không đơn thuần là một cải tiến học thuật, mà đang định hình lại toàn bộ bài toán kinh tế số (Unit Economics) của AI doanh nghiệp năm 2026:
1. Phá vỡ rào cản chi phí suy luận (Cost-Per-Token)
Trước đây, việc vận hành một hệ sinh thái AI Agent phục vụ hàng nghìn lượt tương tác mỗi ngày đòi hỏi doanh nghiệp phải thuê cụm GPU đám mây với chi phí hàng nghìn USD mỗi tháng. Với 1-bit LLMs kết hợp cùng các thư viện suy luận tối ưu như bitnet.cpp, toàn bộ quy trình suy luận có thể chạy mượt mà ngay trên vi xử lý CPU sẵn có (x86 của Intel/AMD hoặc ARM), kéo chi phí cận biên trên mỗi token về gần bằng 0.
2. Hiện thực hóa Private RAG & AI Air-Gapped Tuyệt Đối An Toàn
Các tổ chức thuộc khối ngân hàng, tài chính, y tế và cơ quan chính phủ thường gặp rào cản nghiêm ngặt về bảo mật khi không thể gửi dữ liệu nhạy cảm lên API đám mây công cộng. Với kích thước siêu nhẹ của BitNet, doanh nghiệp có thể dễ dàng thiết lập các cụm máy chủ Private RAG nội bộ (Local RAG) cô lập hoàn toàn khỏi Internet, phân tích hợp đồng và hồ sơ bảo mật ngay tại chi nhánh mà không cần đầu tư hệ thống máy chủ GPU đắt đỏ.
3. Bùng nổ AI On-Device và Trợ Lý Ảo Tại Biên (Edge AI)
Nhờ mức tiêu thụ điện năng tối thiểu, các mô hình 1-bit đã mở đường cho các thiết bị IoT, camera giám sát công nghiệp, POS thông minh và máy bay không người lái thực hiện phân tích ngôn ngữ và suy luận logic tức thì theo thời gian thực mà không cần phụ thuộc vào kết nối mạng băng thông rộng.
Lộ Trình Hành Động Cho Doanh Nghiệp: Khai Thác Sức Mạnh 1-Bit LLM
Để đón đầu và tối đa hóa lợi thế cạnh tranh từ làn sóng 1-bit LLM trong năm 2026, đội ngũ kỹ thuật và lãnh đạo công nghệ doanh nghiệp cần triển khai ngay các bước sau:
- Tận dụng phương pháp Chưng Cất Tri Thức (BitNet Distillation): Thay vì phải tốn hàng triệu USD để huấn luyện mô hình 1-bit từ đầu (From Scratch), hãy sử dụng kỹ thuật Distillation để chuyển giao tri thức từ các mô hình FP16/BF16 hiện tại của doanh nghiệp sang mô hình đích 1.58-bit. Quá trình này giữ lại đến 98% năng lực tư duy chuyên ngành nhưng giảm 85% tài nguyên vận hành.
-
Tích hợp Framework Suy Luận Tối Ưu Hóa CPU: Chuyển đổi hạ tầng suy luận nội bộ sang các runtime chuyên biệt như
bitnet.cpphoặc các kernel tối ưu hóa chỉ lệnh AVX-512 / AMX / ARM NEON. Điều này cho phép doanh nghiệp khai thác 100% công suất của dàn máy chủ văn phòng hiện hữu. - Tái cấu trúc kiến trúc Hybrid Inference (Hỗn hợp Thông minh): Thiết kế luồng điều phối tác vụ thông minh: Các câu hỏi định tuyến, trích xuất thực thể, phân loại tài liệu và Local RAG sẽ được xử lý bởi mô hình 1-bit chạy trên CPU nội bộ; chỉ những bài toán suy luận phức tạp bậc cao mới được ủy quyền cho các Frontier Model trên đám mây.
- Đo lường Chỉ Số "Mật Độ Trí Tuệ" (Intelligence Density): Thay vì chỉ quan tâm đến số lượng tham số đơn thuần, hãy đưa chỉ số Năng lực giải quyết bài toán trên mỗi Watt điện và mỗi USD chi phí vào làm KPI trung tâm trong chiến lược đầu tư công nghệ của doanh nghiệp.
Kết luận: Kỷ nguyên 1-bit LLMs và BitNet b1.58 năm 2026 đang tạo ra bước ngoặt dân chủ hóa trí tuệ nhân tạo. Bằng việc gỡ bỏ xiềng xích phần cứng và chuyển trọng tâm từ "cuộc chạy đua GPU tốn kém" sang "hiệu suất tính toán tối giản trên CPU", công nghệ này trao quyền cho mọi doanh nghiệp xây dựng những hệ thống AI tự trị mạnh mẽ, bảo mật cao với ngân sách tối ưu nhất.