
Trong suốt một thập kỷ qua, toàn bộ đế chế Trí tuệ Nhân tạo tạo sinh (Generative AI) đều được vận hành dựa trên một giả định cốt lõi: mô hình ngôn ngữ lớn (LLM) phải dự đoán từng token một cách tuần tự (Next-Token Prediction). Tuy nhiên, khi bước sang năm 2026, với sự bùng nổ của các chuỗi tác vụ AI Agent tự trị tiêu tốn hàng triệu token mỗi giờ, cơ chế tuần tự truyền thống này đã trở thành "nút thắt cổ chai" chí mạng về cả tốc độ lẫn chi phí GPU. Sự xuất hiện của Multi-Token Prediction (MTP) – phương pháp kiến trúc cho phép AI dự đoán đồng thời nhiều token tương lai trong một lượt tính toán – đang tạo nên cơn địa chấn công nghệ, định hình lại toàn bộ nền kinh tế điện toán và hạ tầng AI doanh nghiệp.
1. "Cơn Ác Mộng Băng Thông" Của Cơ Chế Sinh Token Truyền Thống
Để hiểu vì sao Multi-Token Prediction lại là bước nhảy vọt mang tính sống còn, cần nhìn thẳng vào điểm nghẽn vật lý của kiến trúc Transformer nguyên bản. Trong cơ chế tự hồi quy cổ điển ($P(w_t | w_{
Khác với phương pháp đoán từ đơn lẻ, kiến trúc Multi-Token Prediction (tiêu biểu trong các mô hình thế hệ mới năm 2026 như DeepSeek-V3, Meta FAIR MTP và họ mô hình Nemotron) thiết lập thêm các module MTP chuyên biệt được huấn luyện song song với trục chính của mạng nơ-ron (Main Model Trunk).
Thay vì sử dụng các đầu dự đoán độc lập dễ gây phân mảnh ngữ nghĩa, kiến trúc MTP hiện đại vận hành theo mô hình chuỗi nhân quả liên hoàn (Sequential Causal Chain):
Trước đây, để tăng tốc độ phản hồi thông qua kỹ thuật giải mã suy đoán (Speculative Decoding), các kỹ sư buộc phải triển khai một mô hình nhỏ phụ trợ (Draft Model) chạy song song với mô hình lớn. Quy trình này cực kỳ cồng kềnh, dễ lệch phân phối xác suất và gây đau đầu khi đồng bộ hóa hạ tầng máy chủ.
MTP giải quyết triệt để vấn đề này bằng Native Speculative Decoding:
Sự trưởng thành của Multi-Token Prediction mang lại những lợi ích chiến lược vượt bậc mà mọi nhà lãnh đạo công nghệ (CTO, CIO) cần nắm bắt ngay trong năm 2026:
Do tốc độ sinh token tăng gấp bội trên cùng một phần cứng GPU, thông lượng (throughput) của hệ thống phục vụ người dùng được nâng cao đáng kể. Một cụm máy chủ trước đây chỉ phục vụ được 100 phiên trò chuyện đồng thời thì nay có thể gánh vác dễ dàng 250 - 300 phiên mà không gặp tình trạng nghẽn hàng đợi (queue congestion).
Các nghiên cứu thực nghiệm đã chứng minh: việc buộc AI phải dự đoán trước các khối token giúp mô hình nắm bắt chặt chẽ cú pháp thuật toán, tên biến và cấu trúc hàm phức tạp. Trên các bảng xếp hạng đo lường kỹ thuật phần mềm (SWE-bench, HumanEval), các mô hình áp dụng huấn luyện MTP đều ghi nhận mức tăng điểm từ 12% đến 18% so với mô hình tương đương huấn luyện theo kiểu cũ.
Với độ trễ tạo token đầu tiên (TTFT) và tốc độ phát âm thanh gần như tức thì, các trợ lý ảo đàm thoại thông minh (Full-duplex Voice Agents) loại bỏ hoàn toàn cảm giác ngập ngừng khó chịu, mang lại trải nghiệm giao tiếp tự nhiên y hệt con người.
Để hiện thực hóa lợi ích kinh tế và công nghệ từ Multi-Token Prediction, doanh nghiệp nên triển khai theo quy trình chuẩn hóa gồm 4 bước:
Kết luận: Multi-Token Prediction không đơn thuần là một thủ thuật toán học trong phòng lab, mà là bước chuyển mình mang tính nền tảng đưa Trí tuệ Nhân tạo vượt qua giới hạn vật lý của kiến trúc Transformer truyền thống. Đối với các doanh nghiệp đang bước vào giai đoạn mở rộng quy mô ứng dụng AI năm 2026, làm chủ và ứng dụng MTP chính là chìa khóa then chốt để vừa dẫn đầu về trải nghiệm tốc độ, vừa tối ưu hóa triệt để ngân sách tài chính trên thương trường số.
2. Giải Mã Bản Chất Kỹ Thuật Của Kiến Trúc Multi-Token Prediction (MTP)
Cấu Trúc Module MTP Chaining Độc Đáo
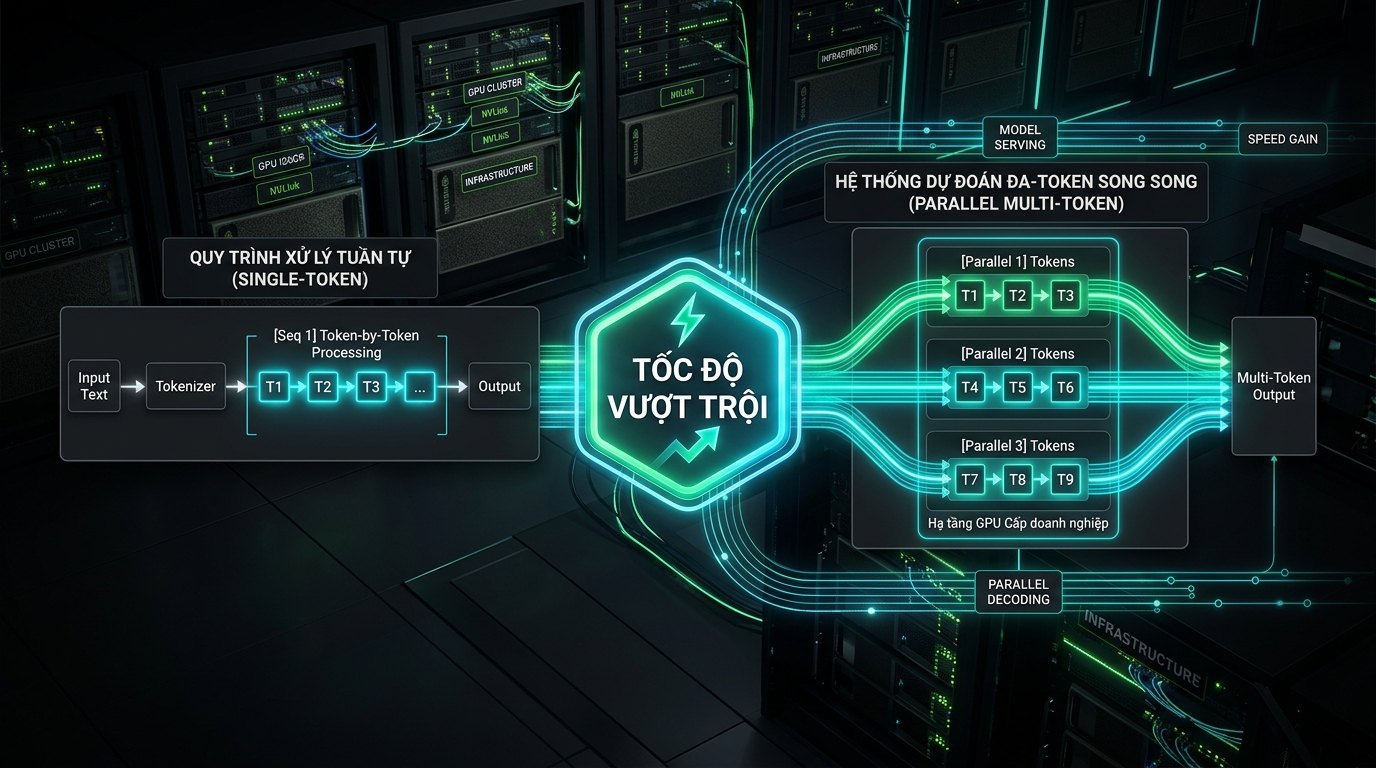 Kiến trúc Multi-Token Prediction (MTP): Dự đoán chuỗi token song song, gia tăng gấp 3 lần tốc độ suy luận và tối ưu hóa chi phí hạ tầng AI doanh nghiệp.
3. Cú Hích Đột Phá: Speculative Decoding Bản Địa Không Cần Draft Model
4. Tác Động Toàn Diện Đến Doanh Nghiệp & Các Nhà Phát Triển
Tối Ưu Hóa Chi Phí TCO Hạ Tầng Máy Chủ (Cắt Giảm Tới 60% Ngân Sách Cloud)
Bước Nhảy Vọt Về Năng Lực Lập Trình (Coding & Reasoning)
Nâng Cấp Trải Nghiệm Tương Tác Giọng Nói & Voice Agent Thời Gian Thực
5. Lộ Trình Hành Động Triển Khai MTP Cho Doanh Nghiệp Năm 2026
vLLM (từ phiên bản v0.7+) hoặc SGLang. Cấu hình cờ khởi chạy --speculative_config '{"method": "mtp", "num_speculative_tokens": 1}' để kích hoạt cơ chế suy đoán MTP tích hợp.