
Bước sang năm 2026, khi nhu cầu xử lý ngữ cảnh siêu dài (Long-Context) bùng nổ, các doanh nghiệp đang phải đối mặt với một bức tường chi phí khổng lồ từ bộ nhớ đệm KV Cache của kiến trúc Transformer truyền thống. Đột phá từ nhóm nghiên cứu Google Research với kiến trúc Titans và khung lý thuyết MIRAS chính thức khai sinh một kỷ nguyên mới: Bộ nhớ nơ-ron dài hạn (Neural Long-Term Memory) – nơi mô hình AI tự học cách ghi nhớ và quên ngay trong lúc suy luận (Test-Time Memorization), vượt mốc 2 triệu token mà không làm nổ tung ngân sách hạ tầng.
"Bức Tường Bộ Nhớ" Transformer & Điểm Nghẽn Triệu Đô Của Doanh Nghiệp
Trong suốt hơn nửa thập kỷ qua, cơ chế tự chú ý (Self-Attention) của Transformer đã trở thành trái tim của cuộc cách mạng GenAI. Tuy nhiên, kiến trúc này mang một "gót chân Achilles" chết người: độ phức tạp tính toán và tiêu thụ bộ nhớ tỷ lệ bậc hai $O(N^2)$ theo độ dài chuỗi ngữ cảnh.
Để duy trì khả năng suy luận trên các văn bản dài—như toàn bộ kho tài liệu pháp lý, mã nguồn repository phần mềm hay hàng trăm trang hồ sơ bệnh án—hệ thống AI phải liên tục lưu trữ toàn bộ các cặp Key và Value vào bộ nhớ VRAM (gọi là KV Cache). Khi độ dài ngữ cảnh vượt qua 100.000 token và tiến đến 1 triệu token:
- Khủng hoảng phần cứng: Dung lượng KV Cache phình to chiếm trọn bộ nhớ HBM3e đắt đỏ của các cụm GPU NVIDIA H100/B200, khiến chi phí phục vụ một phiên truy vấn (Serving Cost) đội lên gấp hàng chục lần.
- Giới hạn của RAG tĩnh: Dù doanh nghiệp đã cố gắng giải cứu bài toán này bằng kiến trúc RAG (Retrieval-Augmented Generation), việc cắt nhỏ dữ liệu (chunking) rồi truy vấn vector thường làm đứt gãy sợi dây liên kết logic toàn cục, dẫn đến tình trạng AI "nhìn từng cái cây mà không thấy cả cánh rừng".
- Sự suy hao của các mô hình RNN/SSM: Các kiến trúc tuyến tính như Mamba hay RWKV tuy giải quyết được tốc độ nhưng lại nén lịch sử vào một trạng thái ẩn (hidden state) cố định, khiến mô hình dễ dàng "bỏ quên" các tiểu tiết quan trọng ở khoảng cách xa (nhiệm vụ Needle In A Haystack).
Giải Mã Kiến Trúc Google Titans: Bộ Não Số Có Cả Trí Nhớ Ngắn Hạn Và Dài Hạn
Được dẫn dắt bởi các nhà nghiên cứu hàng đầu tại Google Research (Ali Behrouz, Peilin Zhong, Vahab Mirrokni), kiến trúc Titans không cố gắng nhồi nhét mọi thứ vào một cửa sổ chú ý khổng lồ. Thay vào đó, Titans mô phỏng chính xác cấu trúc sinh học của não bộ con người bằng cách tách biệt rõ ràng giữa Bộ nhớ làm việc (Working Memory) và Bộ nhớ nơ-ron dài hạn (Neural Long-Term Memory).
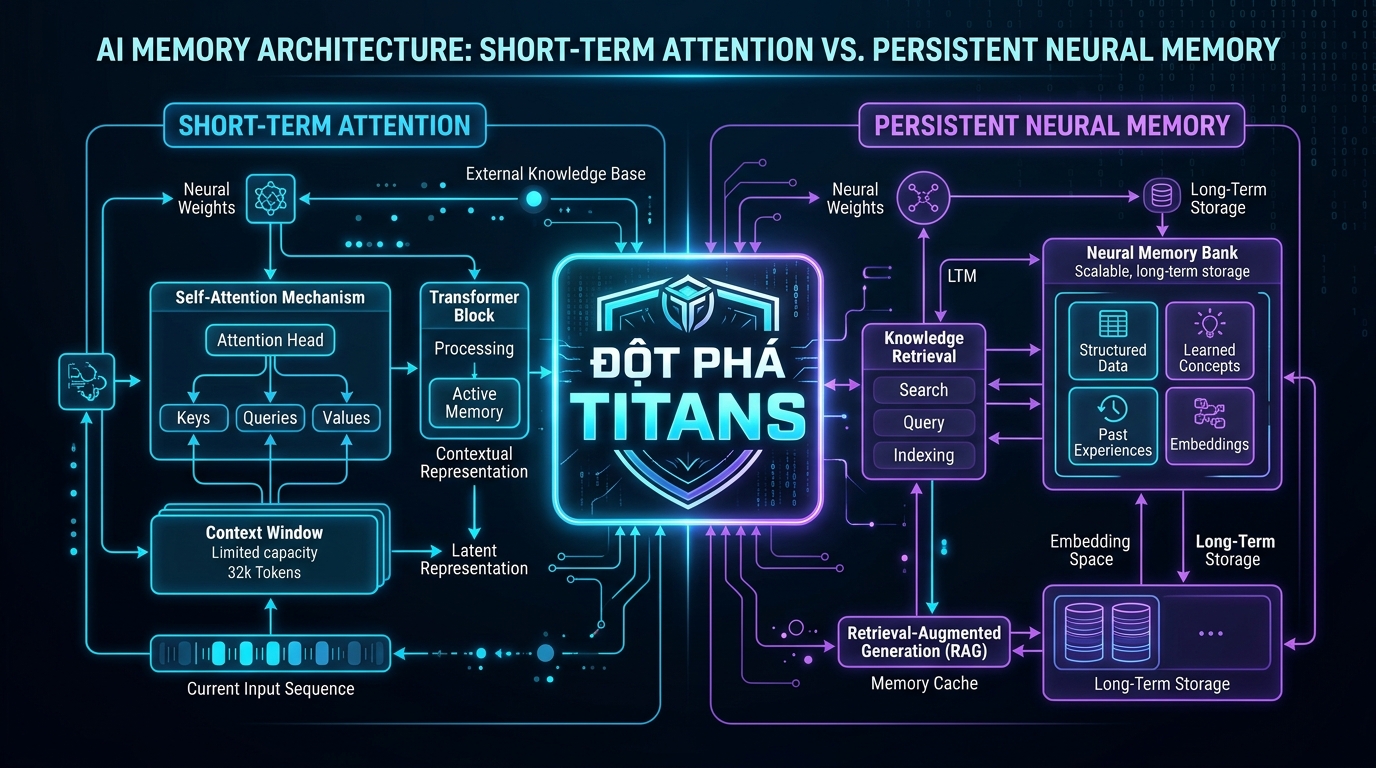 Sơ đồ tổng quan kiến trúc Titans: Kết hợp Attention ngắn hạn, Bộ nhớ nơ-ron dài hạn tự học tại test-time và Persistent Memory
Ba Trụ Cột Cốt Lõi Trong Kiến Trúc Titans
- Core (Bộ nhớ ngắn hạn - Local Attention): Đảm nhận nhiệm vụ chú ý cục bộ với độ phân giải cực cao trong một cửa sổ trượt vừa phải. Bộ phận này chịu trách nhiệm nắm bắt cấu trúc ngữ pháp tức thì và mối quan hệ trực tiếp giữa các từ gần nhau.
- Neural Long-Term Memory (NLM - Bộ nhớ nơ-ron dài hạn): Đây chính là phát minh mang tính cách mạng nhất. Thay vì lưu token thành vector tĩnh trong bộ nhớ ngoài, Titans sử dụng chính một mạng nơ-ron sâu (MLP nhỏ) làm nơi lưu trữ ký ức. Mạng nơ-ron này tự động cập nhật trọng số của mình trong thời gian thực khi mô hình đang đọc tài liệu mà không cần huấn luyện lại từ đầu.
- Persistent Memory (Bộ nhớ tiền định bất biến): Chứa các tham số trọng số cố định được huấn luyện trước, mã hóa các quy tắc nhiệm vụ cốt lõi và kiến thức nền tảng của nhân loại.
Cơ Chế "Surprise Metric": Não Bộ AI Chỉ Ghi Nhớ Điều Thực Sự Bất Ngờ
Bộ não con người không ghi hình lại từng giây của cuộc sống; chúng ta chỉ khắc ghi những sự kiện gây bất ngờ hoặc có ý nghĩa cảm xúc lớn. Titans áp dụng cơ chế toán học tương tự thông qua chỉ số Surprise Metric (Chỉ số Bất ngờ dựa trên Gradient):
- Khi một token đi vào, mô hình đối chiếu với kỳ vọng hiện tại của bộ nhớ dài hạn. Nếu độ bất ngờ cao (gradient sai số lớn), tín hiệu cập nhật mạnh mẽ sẽ được kích hoạt để khắc sâu dữ liệu này vào trọng số của mạng NLM.
- Momentum (Quán tính nhận thức): Khi bắt gặp một chi tiết gây bất ngờ, Titans tự động kích hoạt quán tính để tiếp tục chú ý và ghi nhớ sâu các token theo sau, đảm bảo ngữ cảnh toàn diện không bị đứt đoạn.
- Adaptive Forgetting (Cơ chế Quên Thích Ứng): Để bộ nhớ không bị bão hòa, Titans tích hợp hàm suy giảm có nguyên lý (decay mechanism), nhẹ nhàng xóa mờ các chi tiết thừa thãi hoặc thông tin đã lỗi thời, giữ cho bộ nhớ luôn tinh gọn và linh hoạt.
Khung Lý Thuyết MIRAS & Kỹ Thuật TNT: Chuẩn Hóa Toán Học Cho Trí Nhớ AI
Cùng với Titans, Google công bố khung lý thuyết MIRAS (Memorization, Information Retrieval, and Associative Systems). MIRAS chứng minh bằng toán học rằng việc ghi nhớ thông tin trong AI không phải là chắp vá các tầng tính toán tùy tiện, mà là một bài toán tối ưu hóa liên tục trực tiếp tại thời điểm suy luận (Online Optimization at Inference Time).
Để hiện thực hóa điều này trên cụm phần cứng GPU quy mô lớn, các nhà nghiên cứu đã ứng dụng kỹ thuật TNT (Two-stage Non-linear Training), cho phép xử lý dữ liệu theo khối (chunkwise parallelization). Nhờ đó, việc huấn luyện và vận hành mạng nơ-ron bộ nhớ phi tuyến tính đạt tốc độ tương đương với các kiến trúc tuyến tính nhanh nhất hiện nay, đập tan nghi ngại về độ trễ khi cập nhật trọng số động.
Tác Động Chấn Động Đến Doanh Nghiệp Và Kiến Trúc Sư AI 2026
Sự xuất hiện của Titans và MIRAS mang đến sự đảo chiều chiến lược sâu sắc trong việc xây dựng giải pháp AI doanh nghiệp:
- Xử lý mượt mà trên 2.000.000 token: Trong các bài kiểm tra thực nghiệm "Tìm kim trong đáy bể" (Needle In A Haystack), Titans duy trì độ chính xác gần như hoàn hảo 100% ở độ dài hơn 2 triệu token, vượt trội hoàn toàn so với Llama-3 hay Mamba-2 ở cùng dung lượng bộ nhớ.
- Cắt giảm 60% - 80% chi phí hạ tầng VRAM: Do không còn phải duy trì bảng KV Cache khổng lồ cho các chuỗi hàng trăm nghìn token, nhu cầu bộ nhớ GPU giảm mạnh, cho phép doanh nghiệp vận hành các mô hình ngôn ngữ lớn trên các cụm máy chủ nhỏ gọn hơn nhiều lần.
- Tái định nghĩa tương lai của RAG: Thay vì phải đầu tư hàng chục nghìn USD mỗi tháng cho các hệ thống Vector Database phức tạp kèm pipeline tách đoạn đầy rủi ro, AI Agent trang bị kiến trúc Titans có thể đọc trực tiếp kho tài liệu nội bộ và tự động "tiêu hóa", liên tưởng tri thức dưới dạng mạng nơ-ron liên kết ngữ nghĩa.
- AI Agent sở hữu ký ức liền mạch suốt đời: Nhân viên số (Digital Workers) có thể làm việc liên tục qua nhiều tháng, tương tác với khách hàng qua hàng ngàn phiên hội thoại mà vẫn duy trì được ngữ cảnh và đặc thù riêng mà không gặp phải hội chứng "mất trí nhớ kỹ thuật số".
Lộ Trình Hành Động Cho Doanh Nghiệp Đón Đầu Làn Sóng Neural Memory
Để biến bước tiến công nghệ này thành lợi thế cạnh tranh vượt trội, các nhà lãnh đạo công nghệ (CTO, Head of AI) cần bắt đầu các bước chuẩn bị ngay từ hôm nay:
- Đánh giá lại danh mục RAG hiện hữu: Rà soát các dự án RAG đang gặp vấn đề về mất mát ngữ cảnh hoặc chi phí hạ tầng vector phình to để chuẩn bị chuyển giao sang các mô hình hỗ trợ Neural Long-Term Memory.
- Xây dựng tiêu chuẩn đánh giá Context-Heavy: Thiết lập các bộ dữ liệu kiểm thử (Evaluation Benchmarks) với dữ liệu thực tế của doanh nghiệp có độ dài từ 500k đến 2M token để đo lường khả năng liên tưởng tri thức của mô hình mới.
- Thử nghiệm các biến thể mã nguồn mở của Titans: Triển khai thử nghiệm các phiên bản Titans và mô hình tích hợp khung MIRAS trên môi trường Sandbox để đo lường độ trễ (latency per token) và mức tiết kiệm VRAM thực tế.
- Tái cấu trúc kiến trúc AI Agent: Chuyển dịch tư duy thiết kế Agent từ việc "truy vấn từ điển ngoài" sang "trao quyền ghi nhớ nội tại", giúp các nhân viên AI tự hoàn thiện kỹ năng và dữ liệu sau mỗi ca làm việc.
Kết luận: Google Titans và khung lý thuyết MIRAS không chỉ đơn thuần là một cải tiến nhỏ về mặt thuật toán, mà là một cuộc cách mạng về triết lý thiết kế trí tuệ nhân tạo. Bằng cách trang bị cho mô hình khả năng ghi nhớ nơ-ron dài hạn năng động ngay tại thời điểm suy luận, chúng ta đang chứng kiến sự ra đời của thế hệ AI thực sự có trí nhớ, xóa bỏ vĩnh viễn ranh giới giữa việc xử lý tức thời và tích lũy tri thức trường tồn cho doanh nghiệp.