
Bước sang năm 2026, cuộc đua trí tuệ nhân tạo đã chính thức bước sang kỷ nguyên Post-Training tập trung vào năng lực suy luận sâu sắc (Reasoning Models). Giữa bối cảnh các phương pháp học tăng cường truyền thống như PPO đòi hỏi chi phí hạ tầng khổng lồ và ngốn gấp đôi bộ nhớ GPU, thuật toán GRPO (Group Relative Policy Optimization) nổi lên như một cuộc cách mạng giải phóng tài nguyên. Bằng cách loại bỏ hoàn toàn Critic Model đắt đỏ và chuẩn hóa lợi thế theo nhóm phản hồi, GRPO giúp doanh nghiệp tự huấn luyện những mô hình sở hữu tư duy chuỗi (Chain-of-Thought) vượt trội với chi phí chỉ bằng 1/10 so với trước đây.
Điểm Nghẽn Của PPO Truyền Thống Và Cơn Khát Năng Lực Suy Luận Của Doanh Nghiệp
Trong nhiều năm qua, PPO (Proximal Policy Optimization) kết hợp cùng cơ chế RLHF (Reinforcement Learning from Human Feedback) là tiêu chuẩn vàng để căn chỉnh các mô hình ngôn ngữ lớn. Tuy nhiên, khi các tổ chức tìm cách huấn luyện AI giải quyết các bài toán logic phức tạp như viết code, phân tích dữ liệu tài chính hoặc kiểm toán hợp đồng, kiến trúc PPO nhanh chóng bộc lộ những điểm nghẽn nghiêm trọng:
- Gánh nặng gấp đôi VRAM vì Critic Model: Kiến trúc Actor-Critic của PPO yêu cầu duy trì đồng thời hai mô hình có kích thước tương đương: Policy Model (Actor) để sinh phản hồi và Value Model (Critic) để ước tính điểm số kỳ vọng ở từng bước. Điều này nhân đôi dung lượng VRAM cần thiết, buộc doanh nghiệp phải đầu tư các cụm GPU đắt đỏ.
- Độ trôi dạt và mất ổn định huấn luyện: Việc huấn luyện một Critic Model chính xác cho các tác vụ tư duy nhiều bước là cực kỳ khó khăn. Khi Critic đánh giá sai, sai số sẽ khuếch đại và làm sụp đổ toàn bộ quá trình hội tụ của mô hình chính.
- Chi phí gán nhãn dữ liệu con người quá cao: Đòi hỏi hàng trăm nghìn mẫu dữ liệu phân tích từng bước do chuyên gia con người biên soạn (SFT), khiến việc tùy biến mô hình cho từng doanh nghiệp trở thành đặc quyền xa xỉ.
Giải Mã GRPO: Cuộc Cách Mạng "Học Tăng Cường Không Critic" (Critic-Free RL)
Được khởi xướng từ công trình DeepSeekMath và bùng nổ toàn cầu cùng các mô hình mã nguồn mở như DeepSeek-R1, Group Relative Policy Optimization (GRPO) đã định nghĩa lại hoàn toàn cách một mô hình học cách suy nghĩ. Điểm mấu chốt mang tính đột phá của GRPO là: loại bỏ hoàn toàn Critic Model mà vẫn đảm bảo tính toán chính xác lợi thế học tập (Advantage).
Cơ chế vận hành của GRPO diễn ra theo 4 giai đoạn tinh gọn:
- Group Sampling (Lấy mẫu nhóm phản hồi): Với mỗi câu hỏi hoặc bài toán đầu vào, mô hình sinh ra một nhóm gồm nhiều lời giải khác nhau (thường từ 4 đến 16 phản hồi độc lập).
- Scoring via Verifiers (Chấm điểm qua bộ thẩm định tất định): Thay vì dùng một mạng nơ-ron Critic dự đoán cảm tính, mỗi phản hồi được đưa qua các bộ kiểm tra tự động (RLVR - Reinforcement Learning from Verifiable Rewards), ví dụ như thực thi code xem có vượt qua unit test không, hoặc so sánh kết quả toán học cuối cùng.
- Group-Relative Advantage (Chuẩn hóa lợi thế trong nhóm): GRPO tính toán điểm trung bình và độ lệch chuẩn của cả nhóm câu trả lời. Lợi thế của một câu trả lời đơn lẻ được tính bằng khoảng cách so với điểm trung bình của nhóm: câu trả lời xuất sắc hơn mặt bằng chung nhận thưởng dương, câu trả lời sai sót nhận hình phạt âm.
- Policy Update (Cập nhật chính sách trực tiếp): Trọng số của mô hình được cập nhật trực tiếp dựa trên hàm mục tiêu tối ưu hóa của PPO, tập trung gia tăng xác suất cho những bước suy luận dẫn đến lời giải vượt trội trong nhóm.
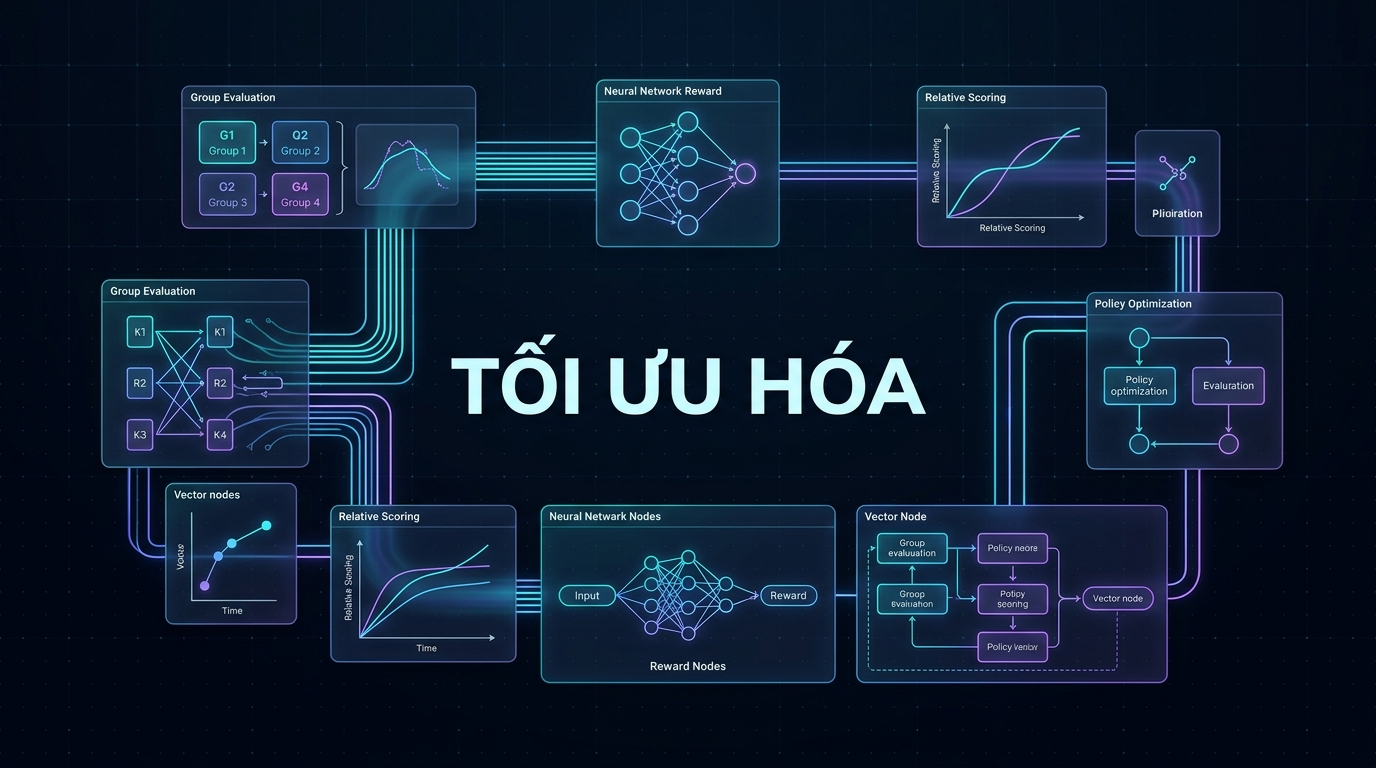 Sơ đồ cơ chế hoạt động của thuật toán GRPO: Triệt tiêu Critic Network và tối ưu hóa lợi thế theo nhóm phản hồi
Những Bước Tiến Đột Phá Năm 2026: Từ Scaf-GRPO Đến Latent-GRPO
Dù GRPO nguyên bản đã tạo nên cơn địa chấn công nghệ, cộng đồng nghiên cứu AI trong năm 2026 đã tiếp tục phát triển các biến thể chuyên sâu nhằm khắc phục triệt để các rào cản kỹ thuật:
1. Scaf-GRPO (Scaffolded GRPO) – Hóa giải "Vách đá học tập"
Khi đối mặt với bài toán quá phức tạp vượt quá năng lực hiện tại của mô hình, toàn bộ các phản hồi trong nhóm đều thất bại và nhận điểm 0. Khi phương sai bằng 0, tín hiệu gradient triệt tiêu hoàn toàn và mô hình ngừng học tập. Scaf-GRPO giải quyết bài toán này bằng cách tự động cung cấp các gợi ý phân tầng (dynamic hints) từ trừu tượng đến cụ thể để tạo lực đẩy ban đầu, giúp mô hình vượt qua vùng bế tắc.
2. S-GRPO – Trị dứt điểm chứng bệnh "Tư duy thừa thãi" (Overthinking)
Trong nỗ lực tìm kiếm phần thưởng, các mô hình suy luận thường có xu hướng kéo dài chuỗi suy nghĩ không cần thiết, tiêu tốn lượng token khổng lồ cho các phép tính đơn giản. Biến thể S-GRPO áp dụng hàm suy giảm phần thưởng theo độ dài (Decaying Rewards), khuyến khích AI tự chấm dứt suy nghĩ và đưa ra kết luận ngay khi phát hiện phương án tối ưu.
3. Latent-GRPO – Tư duy tiềm ẩn không cần sinh văn bản
Thay vì phải ép mô hình xuất ra hàng nghìn token văn bản tường minh để diễn giải quá trình tư duy, Latent-GRPO huấn luyện mô hình thực hiện các bước suy luận bên trong không gian biểu diễn liên tục (Continuous Latent Space). Kỹ thuật này giúp tăng tốc độ suy luận lên gấp 4 lần và giảm đáng kể độ trễ cho các ứng dụng thời gian thực.
Lợi Ích Thực Chiến Cho Doanh Nghiệp: Bình Dân Hóa AI Suy Luận Chuyên Sâu
Sự trỗi dậy của GRPO không chỉ là thành tựu học thuật mà mở ra lợi thế cạnh tranh sống còn cho mọi doanh nghiệp:
- Tiết kiệm 80% chi phí phần cứng: Nhờ loại bỏ Critic Model, các doanh nghiệp vừa và nhỏ hoàn toàn có thể fine-tune các mô hình mã nguồn mở (như Qwen, Llama hoặc DeepSeek) trên các cụm máy chủ cục bộ hoặc thuê đám mây phổ thông mà không cần tới siêu máy tính đắt đỏ.
- Mở khóa khoảnh khắc "Aha Moment" và tự sửa sai (Self-Correction): GRPO kích thích khả năng tự suy ngẫm, phát hiện lỗ hổng logic trong các bước trước và tự động quay lui (backtracking) để chọn phương án tốt hơn – yếu tố sống còn cho các tác vụ tự động hóa quyết định.
- Chủ quyền dữ liệu và mô hình chuyên ngành: Doanh nghiệp không cần gửi dữ liệu nhạy cảm lên các mô hình thương mại đóng độc quyền. Thay vào đó, bạn có thể tự huấn luyện một "chuyên gia số" am hiểu tường tận luật lệ kế toán, quy chế nội bộ hoặc mã nguồn riêng của công ty.
Cạm Bẫy Thực Tiễn: Những Điều Kỹ Sư Cần Cảnh Giác
Dù sở hữu tiềm năng to lớn, việc triển khai GRPO trong doanh nghiệp vẫn đối mặt với những thách thức đòi hỏi sự quản trị chặt chẽ:
- Hiểm họa Gian lận phần thưởng (Reward Hacking): Nếu hàm Verifier được thiết kế lỏng lẻo, AI sẽ tìm ra các "mẹo" cú pháp để nhận điểm số tối đa mà nội dung bên trong hoàn toàn vô nghĩa. Việc xây dựng Verifier nghiêm ngặt là yêu cầu tiên quyết.
- Phù hợp nhất với bài toán có thể thẩm định (Verifiable Tasks): GRPO phát huy sức mạnh vượt trội với Toán học, Viết mã lệnh, Định dạng JSON/SQL hoặc Trích xuất dữ liệu có cấu trúc. Đối với các tác vụ mang tính chủ quan như viết văn sáng tạo hay dịch thuật cảm xúc, cần kết hợp thêm mô hình trọng tài AI (LLM-as-a-Judge) được kiểm chuẩn.
Lộ Trình 4 Bước Triển Khai GRPO Cho Doanh Nghiệp
Để đưa công nghệ GRPO vào dây chuyền sản xuất nội bộ một cách an toàn và hiệu quả, doanh nghiệp nên bám sát lộ trình 4 giai đoạn:
- Xác định miền bài toán tất định: Lựa chọn các bài toán nghiệp vụ có tiêu chí đúng/sai rõ ràng: kiểm tra cú pháp hợp đồng, tự động giải bài toán trích xuất bảng biểu tài chính, hoặc sinh mã SQL từ câu hỏi nghiệp vụ.
- Xây dựng Engine thẩm định tự động (Verifier Pipeline): Thiết kế các bộ kiểm tra tự động chạy ngầm (sandbox unit tests, schema validators, compiler checks) để chấm điểm phản hồi với độ trễ tối thiểu và độ tin cậy 100%.
- Cân chỉnh kích thước nhóm lấy mẫu (Group Size): Bắt đầu với $G = 4$ đến $G = 8$ phản hồi trên mỗi prompt để cân bằng giữa mức độ bao phủ không gian giải pháp và chi phí suy luận trong quá trình huấn luyện.
- Áp dụng giới hạn ngân sách tư duy (Thinking Budget): Khi triển khai mô hình vào thực tế, tích hợp cơ chế Dynamic Thinking Budget nhằm kiểm soát độ dài chuỗi suy luận, đảm bảo thời gian phản hồi cho người dùng cuối dưới 1 giây.
Kết luận: GRPO không chỉ đơn thuần là một cải tiến toán học trong học tăng cường, mà là ngọn cờ đầu bình dân hóa năng lực suy luận chuyên sâu cho toàn bộ hệ sinh thái AI doanh nghiệp năm 2026. Bằng cách loại bỏ gánh nặng của Critic Network và biến các bài kiểm tra thực tế thành động cơ tự hoàn thiện, GRPO trao quyền cho mọi tổ chức tự chủ sở hữu những "bộ não số" tinh hoa với chi phí tối ưu nhất.