Bài viết hữu ích

Tổng hợp bài viết hướng dẫn, kinh nghiệm và mẹo hay

Đang lọc theo tag: llm inference Xóa bộ lọc
Kỷ Nguyên Multi-Head Latent Attention (MLA) 2026: Đột Phá Nén 90  KV Cache Đập Tan 'Bức Tường VRAM' Và Bình Dân Hóa AI Doanh Nghiệp

Kỷ Nguyên Multi-Head Latent Attention (MLA) 2026: Đột Phá Nén 90 KV Cache Đập Tan 'Bức Tường VRAM' Và Bình Dân Hóa AI Doanh Nghiệp

Khám phá cách kiến trúc Multi-Head Latent Attention (MLA) và kỹ thuật hấp thụ trọng số (Weight Absorption) năm 2026 giải phóng thắt nút cổ chai KV Cache, cắt giảm hơn 90 bộ nhớ GPU và giúp doanh nghiệp vận hành AI suy luận sâu với chi phí tối ưu kỷ lục.

01/10/2026 36 lượt xem
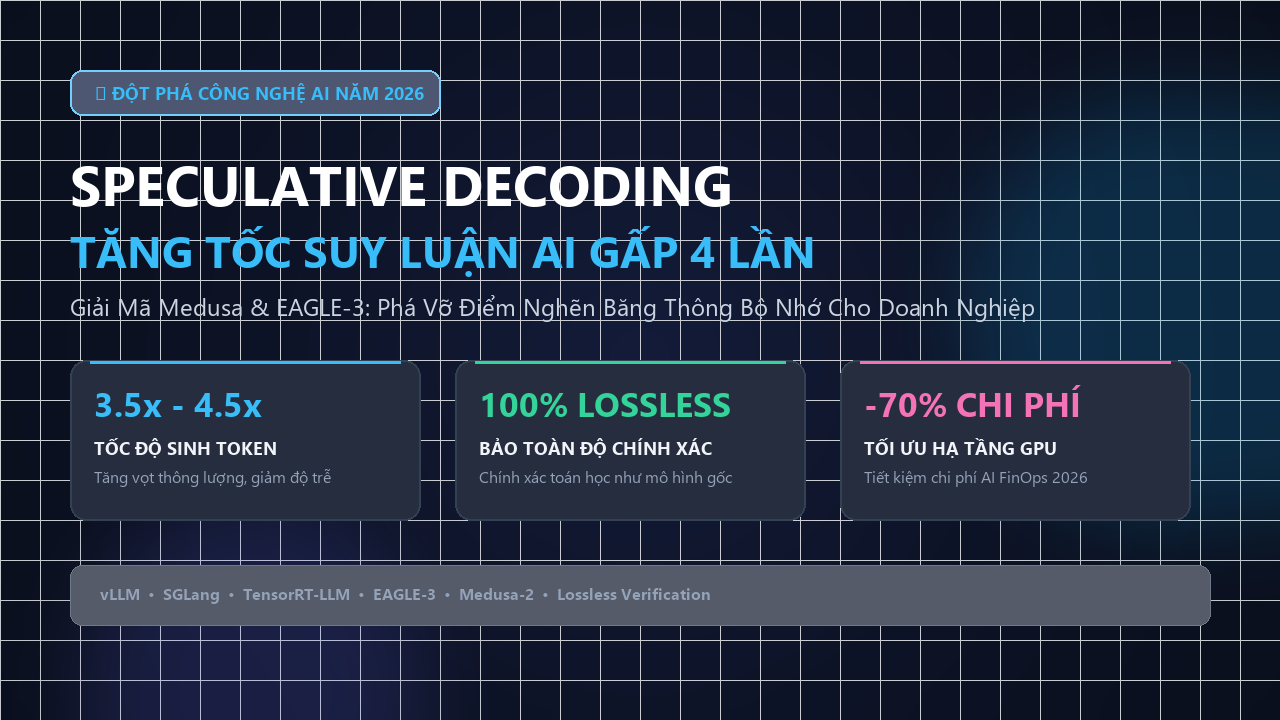
Kỷ Nguyên Speculative Decoding 2026: Đột Phá Tăng Tốc LLM Gấp 4 Lần Và Lời Giải Cho Bài Toán Chi Phí Hạ Tầng AI Doanh Nghiệp

Kỷ Nguyên Speculative Decoding 2026: Đột Phá Tăng Tốc LLM Gấp 4 Lần Và Lời Giải Cho Bài Toán Chi Phí Hạ Tầng AI Doanh Nghiệp

Khám phá Speculative Decoding cùng kiến trúc Medusa và EAGLE-3 trong năm 2026 – đột phá công nghệ giúp phá vỡ điểm nghẽn băng thông bộ nhớ GPU, tăng tốc độ suy luận LLM từ 3x đến 4.5x hoàn toàn lossless và cắt giảm tới 70% chi phí hạ tầng AI doanh nghiệp.

16/09/2026 47 lượt xem