
Năm 2026 chứng kiến một sự chuyển dịch mang tính bước ngoặt trong chiến lược AI doanh nghiệp: Thay vì tiếp tục đổ hàng triệu USD chạy đua nâng cấp các mô hình ngôn ngữ lớn (LLM), các nhà lãnh đạo công nghệ nhận ra rằng rào cản lớn nhất kìm hãm ROI chính là "bãi rác dữ liệu" và các đường ống truyền tải (Data Pipelines) thường xuyên đổ vỡ. Đây chính là lúc Agentic Data Engineering (Kỹ nghệ dữ liệu tự trị) bước lên vũ đài công nghệ, mở ra kỷ nguyên nơi các mạng lưới AI Agent chuyên trách tự động thiết kế, vận hành, kiểm định chất lượng và tự sửa chữa dữ liệu theo thời gian thực.
1. Nghịch Lý Dữ Liệu 2026: Khi Mô Hình AI Càng Thông Minh, Hạ Tầng Càng Dễ Đứt Gãy
Trong nhiều năm, các kỹ sư dữ liệu (Data Engineers) luôn phải chịu đựng một thực tế khắc nghiệt: hơn 70% đến 80% thời gian làm việc hàng ngày bị tiêu tốn vào các hoạt động "chữa cháy" thủ công. Chỉ cần một nhà cung cấp bên thứ ba âm thầm thay đổi cấu trúc API, hay một trường dữ liệu người dùng bị đổi tên (Schema Drift), hàng loạt pipeline ETL/ELT sẽ ngay lập tức bị sập đổ dây chuyền.
Bước sang năm 2026, nghịch lý này trở nên trầm trọng hơn bao giờ hết khi các doanh nghiệp triển khai hàng loạt hệ thống AI tự trị, Agentic GraphRAG và các ứng dụng đưa ra quyết định kinh doanh theo thời gian thực. Một điểm đứt gãy nhỏ trong pipeline dữ liệu thô (Upstream) không chỉ làm chậm báo cáo BI như trước đây, mà có thể trực tiếp làm sai lệch toàn bộ chuỗi suy luận của các hệ thống AI tác nghiệp, gây ra tổn thất tài chính và rủi ro pháp lý nghiêm trọng.
2. Kiến Trúc Agentic Data Engineering: Vòng Lặp Nhận Thức Khép Kín
Khác biệt căn bản giữa kỹ thuật dữ liệu truyền thống và Agentic Data Engineering nằm ở việc chuyển dịch từ các kịch bản tĩnh được lập trình sẵn sang mạng lưới tác tử tự chủ có khả năng thích ứng. Thay vì chờ đợi hệ thống báo lỗi rồi kỹ sư con người vào can thiệp, các AI Agent chuyên trách trong Data Lakehouse vận hành theo vòng lặp nhận thức liên tục:
- Observe (Quan sát chủ động): AI Agent liên tục lắng nghe và giám sát siêu dữ liệu (Metadata), độ trễ truyền tải, lưu lượng phân phối và tính tương thích của cấu trúc schema tại mọi điểm nút trong đường ống dữ liệu.
- Reason (Suy luận nguyên nhân cốt lõi): Khi xuất hiện biến động bất thường (ví dụ: trường
user_idđột ngột mang giá trị null hoặc đổi kiểu dữ liệu thành chuỗi ký tự), Agent phân tích đồ thị quan hệ phụ thuộc để xác định chính xác nguồn gốc lỗi thay vì chỉ ghi log lỗi chung chung. - Act (Tự động phục hồi & Thích ứng): Agent tự động viết mã điều hợp (Auto-Adapter), sinh mã biến đổi tương thích tạm thời, thử nghiệm trong môi trường cô lập (Sandbox) và tự động cập nhật pipeline mà không làm gián đoạn luồng dữ liệu đang chạy.
- Remember (Ghi nhớ tri thức kiến trúc): Toàn bộ giải pháp xử lý sự cố được lưu trữ vào kho vector tri thức dài hạn, giúp hệ thống ngày càng thông minh hơn và xử lý tức thì các sự cố tương tự trong tương lai.
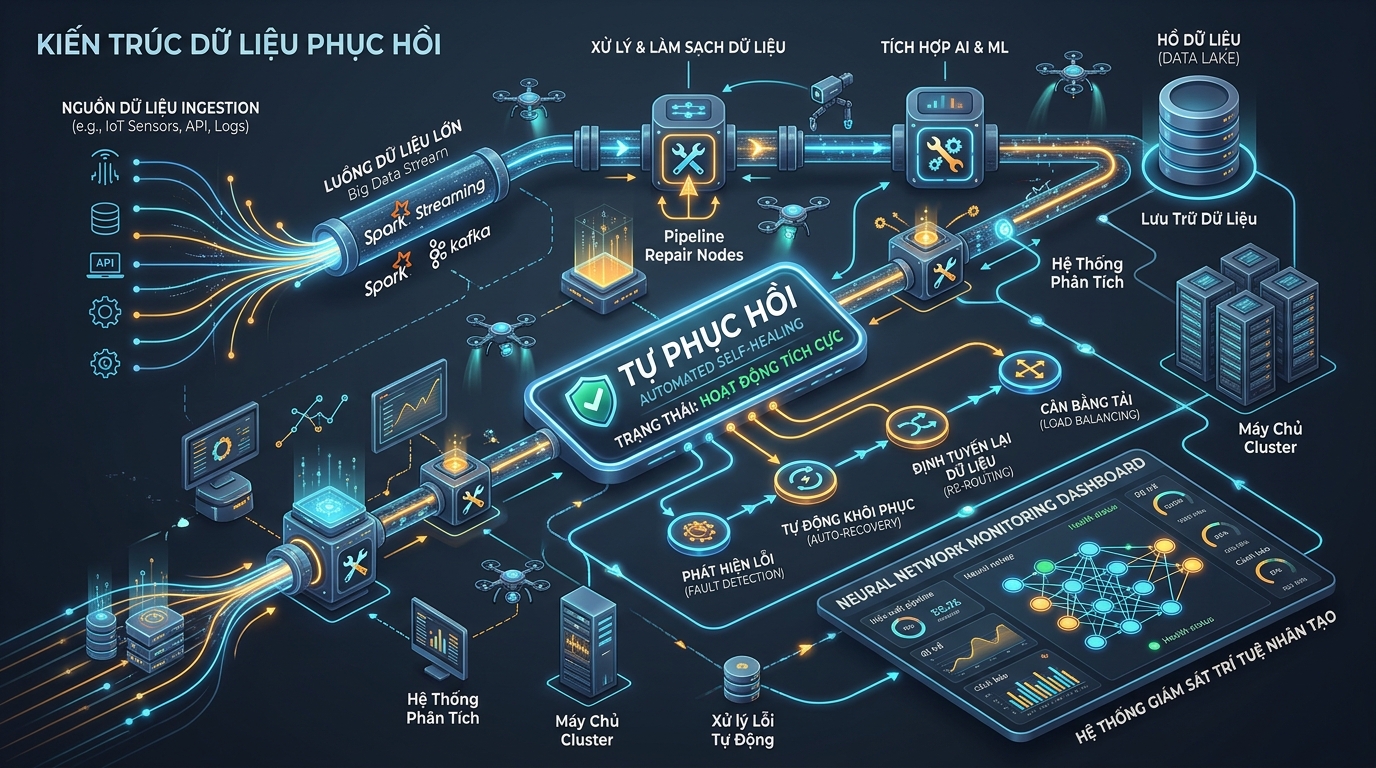
Sơ đồ luồng tự phục hồi (Self-Healing) tự động phát hiện, sửa lỗi và định tuyến lại dữ liệu của AI Agent thời gian thực.
3. Ba Trụ Cột Đột Phá Khai Tử Bế Tắc Vận Hành
3.1. Đường Ống Dữ Liệu Tự Phục Hồi (Self-Healing Pipelines)
Khả năng tự phục hồi là bước nhảy vọt ấn tượng nhất của Agentic Data Engineering. Khi một điểm lỗi mạng xảy ra hoặc cụm máy chủ xử lý Spark bị quá tải, Agent có quyền năng tự động tái phân phối khối lượng tải công việc (Load Balancing), định tuyến lại dữ liệu qua các kênh dự phòng và tự động gửi mã vá lỗi pull-request để đồng bộ lại schema mới mà không cần sự can thiệp của con người vào lúc nửa đêm.
3.2. Hợp Đồng Dữ Liệu Thực Thi Tự Động (Executable Data Contracts)
Năm 2026, hợp đồng dữ liệu không còn là những văn bản cam kết SLA mang tính hình thức giữa các phòng ban. Dưới mô hình Agentic Data Engineering, hợp đồng dữ liệu được số hóa thành các quy chuẩn khai báo (Declarative Policies). AI Agent đóng vai trò là trọng tài bảo vệ: nếu nguồn dữ liệu đầu vào vi phạm tiêu chuẩn cam kết (sai định dạng, thiếu khóa chính, rò rỉ thông tin PII nhạy cảm), Agent sẽ chủ động cô lập lô dữ liệu đó, làm sạch theo quy định và kích hoạt cảnh báo thông minh đến đội ngũ phụ trách.
3.3. Tích Hợp Vạn Năng Qua Giao Thức MCP (Model Context Protocol)
Nhờ việc chuẩn hóa giao thức MCP trong năm 2026, các AI Agent chuyên về dữ liệu có thể tương tác liền mạch với mọi nền tảng lưu trữ hiện đại như Snowflake, Databricks, BigQuery hay PostgreSQL. AI Agent không chỉ đọc và viết dữ liệu mà còn hiểu sâu sắc bảng danh mục dữ liệu (Data Catalogs) và lịch sử biến đổi (Data Lineage) của toàn doanh nghiệp.
4. Định Hình Lại Vai Trò Kỹ Sư Dữ Liệu: Từ 'Thợ Sửa Ống Nước' Thành 'Kiến Trúc Sư Hệ Thống'
Nhiều người lo ngại Agentic AI sẽ xóa sổ vị trí Data Engineer, nhưng thực tế năm 2026 chứng minh điều hoàn toàn ngược lại. Công nghệ này đóng vai trò như một đòn bẩy năng suất khổng lồ:
- Giải phóng 80% thời gian bảo trì vụn vặt: Kỹ sư không còn phải ngồi viết các câu lệnh biến đổi dữ liệu lặp đi lặp lại hay trực tiếp đi dò từng dòng log lỗi mỗi khi pipeline đứt gãy.
- Nâng tầm vai trò chiến lược: Con người tập trung vào việc hoạch định kiến trúc tổng thể, bảo mật dữ liệu doanh nghiệp và xây dựng tầng ngữ nghĩa (Semantic Layer) chuẩn xác cho các mục tiêu kinh doanh.
- Rút ngắn chu kỳ ra mắt sản phẩm: Việc tích hợp một nguồn dữ liệu mới từ trước đây mất hàng tuần phát triển nay được rút ngắn xuống chỉ còn vài chục phút thông qua các lệnh mô tả ý định (Intent-based prompts) cho AI Agent.
5. Lộ Trình 4 Bước Triển Khai Cho Doanh Nghiệp
- Bước 1 - Chuẩn hóa Tầng Ngữ Nghĩa (Semantic Layer): Xây dựng từ điển dữ liệu chuẩn về các chỉ số cốt lõi (doanh thu thuần, khách hàng active, giá trị vòng đời) để AI Agent có căn cứ đối chiếu chính xác.
- Bước 2 - Vận hành chế độ Thử Nghiệm Ngầm (Shadow Mode): Để AI Agent theo dõi và đề xuất các phương án khắc phục pipeline trong 4 đến 6 tuần dưới sự xét duyệt của kỹ sư (Human-in-the-loop) nhằm đo lường mức độ tin cậy.
- Bước 3 - Thiết lập Hợp Đồng Dữ Liệu Tự Động: Tích hợp các quy tắc kiểm thử chất lượng dữ liệu tự động ngay tại các điểm đầu vào của hệ thống Data Lakehouse.
- Bước 4 - Phân quyền tự trị tiến tiến (Progressive Autonomy): Từng bước cấp quyền cho AI Agent tự động sửa lỗi và merge code trên môi trường Production đối với các kịch bản sự cố thông thường, tiến tới tự hành 100%.
Kết luận: Năm 2026 đánh dấu bước trưởng thành vượt bậc của làn sóng AI doanh nghiệp, nơi trọng tâm dịch chuyển từ các mô hình ngôn ngữ khổng lồ sang việc xây dựng một hạ tầng dữ liệu thông minh, kiên cường và tự thích ứng. Agentic Data Engineering chính là nền móng vững chắc nhất để biến nguồn tài nguyên dữ liệu tĩnh thành dòng chảy tri thức sống động, đem lại lợi thế cạnh tranh áp đảo cho các tổ chức tiên phong.