
Suốt gần một thập kỷ qua, kể từ khi kiến trúc Transformer ra đời vào năm 2017, toàn bộ thế giới Trí tuệ Nhân tạo gần như được xây dựng dựa trên một giáo điều duy nhất: Mô hình Tự hồi quy (Autoregressive Models - ARMs). Từ GPT-4, Claude 3.5 cho đến Llama 3 hay DeepSeek-V3, mọi câu chữ đều được sinh ra tuần tự từng từ một từ trái sang phải (Next-Token Prediction). Tuy nhiên, bước sang năm 2026, nút thắt cơ bản của cơ chế này đã dần lộ rõ. Sự trỗi dậy mạnh mẽ của Diffusion Language Models (dLLMs) — dẫn đầu bởi các đột phá như LLaDA và iLLaDA — đang chính thức mở ra một kỷ nguyên mới: sinh ngôn ngữ phi tuần tự, thấu hiểu ngữ cảnh hai chiều toàn diện và tái định hình toàn bộ hạ tầng AI doanh nghiệp.
1. Giới Hạn Cố Hữu Của Kiến Trúc Autoregressive Truyền Thống
Để hiểu được tầm vóc của cuộc cách mạng Diffusion Language Models, trước hết chúng ta cần nhìn thẳng vào những điểm nghẽn kiến trúc mà các mô hình Autoregressive (AR) đang đối mặt khi quy mô triển khai doanh nghiệp bùng nổ:
- Sự phụ thuộc tuần tự nghiêm ngặt (Sequential Bottleneck): Để sinh ra token thứ 1.000, mô hình bắt buộc phải chạy qua 999 bước suy luận trước đó. Không có cách nào để song song hóa quá trình sinh (decoding), biến GPU mạnh mẽ trở thành những cỗ máy bị giới hạn bởi băng thông bộ nhớ (memory-bandwidth bound).
- Nỗi ám ảnh bộ nhớ KV Cache: Mỗi token sinh ra đòi hỏi lưu trữ các vector Key-Value. Khi phục vụ hàng triệu người dùng đồng thời hoặc xử lý văn bản dài hàng trăm nghìn token, dung lượng VRAM bị nuốt chửng bởi KV Cache, đẩy chi phí vận hành hạ tầng lên mức phi mã.
- Lời nguyền đảo ngược (The Reversal Curse): Do chỉ được huấn luyện nhìn về một hướng (Causal Masking), mô hình AR rất dễ mắc bẫy suy luận logic đảo chiều. Khi biết "A là mẹ của B", mô hình AR chưa chắc đã suy luận được "B là con của ai".
- Bất lực trước việc biên tập tùy ý (Infilling & Arbitrary Editing): Khi một lập trình viên muốn sửa một hàm nằm ở giữa đoạn code 10.000 dòng, mô hình AR phải sinh lại toàn bộ đoạn mã phía sau thay vì chỉ cập nhật chính xác vị trí bị lỗi.
2. Bản Chất Kỹ Thuật: Diffusion Language Models (dLLMs) Hoạt Động Như Thế Nào?
Nếu như các mô hình Diffusion hình ảnh (như Stable Diffusion hay Midjourney) bắt đầu từ một khung hình đầy nhiễu Gaussian ngẫu nhiên rồi khử nhiễu dần qua từng bước, thì Diffusion Language Models áp dụng nguyên lý tương tự lên không gian rời rạc (Discrete Masked Diffusion).
Cơ Chế Discrete Masking & Denoising Đa Tầng
Điển hình như mô hình LLaDA (Large Language Diffusion with Masking) và thế hệ nâng cấp iLLaDA, quy trình hoạt động được tái cấu trúc hoàn toàn:
- Quá trình khuếch tán xuôi (Forward Process): Đoạn văn bản hoặc mã nguồn bị làm suy biến ngẫu nhiên bằng cách thay thế các token bằng token đặc biệt
[MASK]theo các mức xác suất khác nhau. - Quá trình khuếch tán ngược (Reverse Denoising Process): Mô hình Transformer với cơ chế Fully Bidirectional Attention (chú ý hai chiều hoàn toàn) sẽ dự đoán đồng thời tất cả các vị trí bị che giấu trong một số lượng bước khử nhiễu cố định ($T$).
- Quy hoạch toàn cục (Global Planning): Thay vì quyết định từng từ một cách "mù mờ" mà không biết kết thúc câu sẽ ra sao, dLLM có cái nhìn toàn cảnh về toàn bộ văn bản ngay từ bước đầu tiên, từ đó tinh chỉnh cấu trúc câu và lập luận logic một cách hài hòa và mạch lạc.
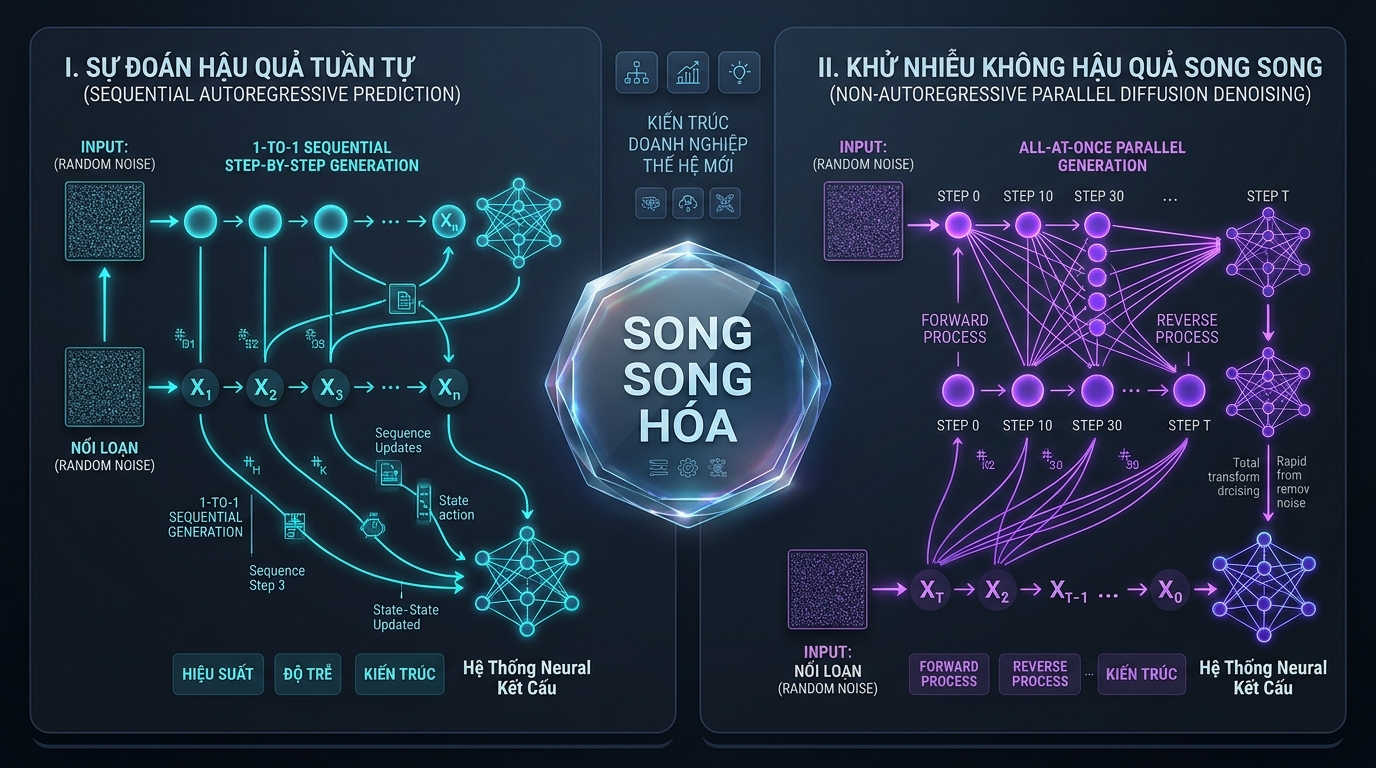
Sơ đồ so sánh: Mô hình Tự hồi quy sinh tuần tự từng bước (trên) so với Mô hình Khuếch tán Ngôn ngữ khử nhiễu song song toàn cục qua các bước cố định (dưới).
3. Những Bước Nhảy Vọt Khiến dLLM Trở Thành "Vũ Khí Chiến Lược" 2026
1. Phá Vỡ Tốc Độ Sinh Bằng Tính Toán Song Song (Non-Autoregressive)
Trong mô hình tự hồi quy, thời gian sinh văn bản tỷ lệ thuận với số lượng token đầu ra ($O(N)$). Nhưng với dLLM, thời gian sinh phụ thuộc vào số bước khuếch tán ($T$), cho phép tạo ra hàng trăm hoặc hàng nghìn token chỉ trong một vài bước khử nhiễu song song. Điều này khai phóng tối đa sức mạnh tính toán song song khổng lồ của các cụm GPU hiện đại.
2. Triệt Tiêu "Reversal Curse" Nhờ Ngữ Cảnh Hai Chiều Tuyệt Đối
Các nghiên cứu thực nghiệm trên LLaDA 8B và iLLaDA cho thấy dLLM vượt trội hoàn toàn so với các mô hình AR (kể cả GPT-4o) trong các bài kiểm tra suy luận đảo chiều. Do nhìn thấy cả tiền ngữ cảnh và hậu ngữ cảnh cùng lúc, khả năng kết nối tri thức thực tế của dLLM đạt độ tin cậy vượt bậc, hạn chế tối đa hiện tượng "ảo giác logic".
3. Khả Năng Điền Khuyết (Infilling) & Chỉnh Sửa Mã Nguồn Siêu Tốc
Đây là "chén thánh" cho các trợ lý lập trình (AI Coding Agents). Khi cần refactor hay vá lỗ hổng trong một file code phức tạp, dLLM chỉ cần mask đúng đoạn mã cần sửa và thực hiện khử nhiễu tại chỗ, giữ nguyên vẹn 100% ngữ cảnh xung quanh mà không làm đứt gãy luồng logic hay phát sinh lỗi ngoài ý muốn.
4. Giải Thoát Áp Lực Bộ Nhớ & Chi Phí Hạ Tầng
Bởi vì không cần duy trì một hàng đợi KV Cache tích lũy liên tục theo từng token, dLLM mở ra tiềm năng tối ưu hóa kiến trúc bộ nhớ VRAM ngoạn mục, cho phép doanh nghiệp tăng mật độ phục vụ (concurrency) lên gấp nhiều lần trên cùng một máy chủ phần cứng.
4. Tác Động Sâu Rộng Đến Doanh Nghiệp & Các Ngành Nghề Năm 2026
Sự chuyển dịch sang dLLM không chỉ dừng lại ở lý thuyết phòng lab mà đang trực tiếp định hình lại các giải pháp công nghệ trọng yếu:
- Autonomous Software Engineering: Các Agent lập trình tự trị có thể rà soát toàn bộ dự án, đồng thời đề xuất hàng chục bản vá mã nguồn tại nhiều vị trí khác nhau mà không bị nghẽn độ trễ.
- Xử lý và chuẩn hóa tài liệu pháp lý, tài chính: Khả năng đọc hiểu hai chiều giúp dLLM rà soát các hợp đồng hàng trăm trang, đối chiếu chéo các điều khoản mâu thuẫn giữa phần mở đầu và phụ lục một cách hoàn hảo.
- Hệ thống Đối thoại Thời gian thực (Real-time Full-Duplex AI): Kết hợp bước nhảy dLLM với khả năng sửa đổi câu từ tức thì khi người dùng chen ngang (interruption), giúp tổng đài viên số phản hồi thông minh và liền mạch hơn bao giờ hết.
5. Lộ Trình Hành Động Cho Doanh Nghiệp Thời Kỳ Hậu Autoregressive
Để đón đầu làn sóng dLLMs và không bị tụt lại phía sau, các nhà lãnh đạo công nghệ và kỹ sư AI cần xây dựng chiến lược thích ứng rõ ràng:
- Tái đánh giá kiến trúc phục vụ (Serving Stack): Bắt đầu thử nghiệm các runtime và inference engine hỗ trợ song song hóa phi tuần tự thay vì chỉ tối ưu hóa độc quyền cho KV Cache vLLM/TensorRT-LLM truyền thống.
- Ứng dụng mô hình lai (Hybrid ARM-dLLM Pipeline): Tận dụng sức mạnh của các mô hình AR trong khâu lập luận tư duy dài (reasoning chain) và chuyển giao khâu sinh mã nguồn, biên tập chi tiết và kiểm thử cho dLLM để đạt hiệu quả chi phí tối ưu nhất.
- Chuẩn hóa quy trình kiểm thử với Infilling Benchmark: Đo lường năng lực của hệ thống AI nội bộ trên các tác vụ chỉnh sửa tài liệu và refactor mã nguồn cục bộ để khai thác triệt để thế mạnh chỉnh sửa tại chỗ của dLLM.
Kết luận: Sự xuất hiện của Diffusion Language Models không đơn thuần là một mô hình mới, mà là phát súng mở màn cho cuộc tái cấu trúc nền tảng sinh ngôn ngữ trong Trí tuệ Nhân tạo. Bằng việc giải phóng AI khỏi xiềng xích của việc dự đoán tuần tự từng token, dLLM mở ra kỷ nguyên của sự chính xác toàn cục, tốc độ song song vượt trội và hiệu suất kinh tế bền vững cho mọi doanh nghiệp tiên phong trong năm 2026.