
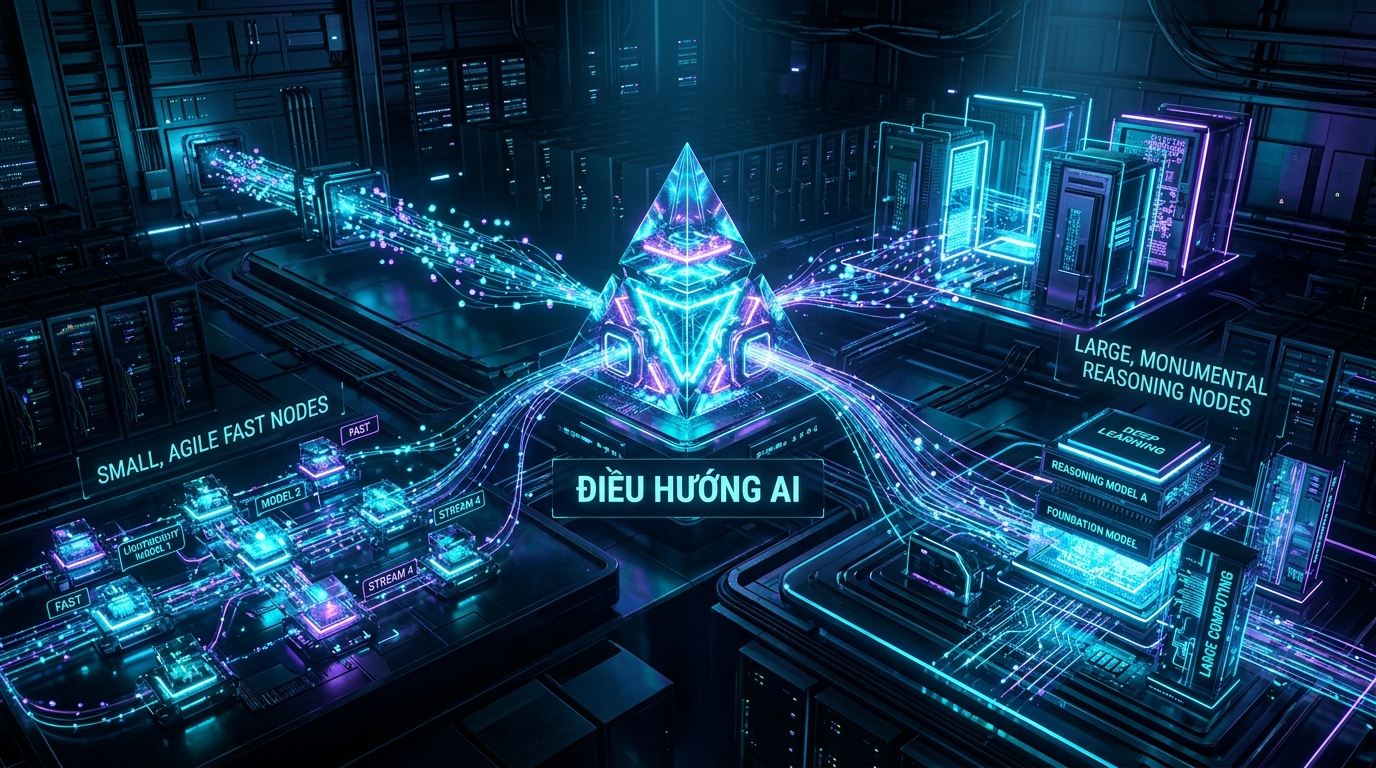
Bước sang năm 2026, khi các hệ thống AI Agent tự trị và tự động hóa doanh nghiệp mở rộng quy mô từ hàng ngàn lên hàng triệu truy vấn mỗi ngày, một nghịch lý lớn đã xuất hiện: Nếu gửi toàn bộ tác vụ đến các siêu mô hình suy luận hàng đầu (Frontier Reasoning Models), ngân sách điện toán sẽ nhanh chóng cạn kiệt; nhưng nếu chỉ dùng mô hình nhỏ, chất lượng xử lý tác vụ phức tạp sẽ sụp đổ. Để hóa giải điểm nghẽn sống còn này, các kỹ sư hệ thống hàng đầu thế giới đã định hình nên một chuẩn mực kiến trúc bắt buộc: Dynamic Model Routing & Cascading Inference (Điều hướng mô hình động & Suy luận phân tầng) – chiếc chìa khóa vàng giúp doanh nghiệp tiết kiệm 40% - 85% chi phí vận hành mà vẫn duy trì độ chính xác ở mức tối thượng.
1. Khai Tử Tư Duy 'Một Mô Hình Cho Tất Cả': Căn Bệnh Lãng Phí Điện Toán Doanh Nghiệp
Trong giai đoạn sơ khai của làn sóng GenAI (2023 - 2024), đa số các ứng dụng doanh nghiệp đều mắc phải một sai lầm kiến trúc cơ bản: trỏ thẳng một API endpoint duy nhất (chẳng hạn GPT-4 hoặc Claude 3.5 Sonnet) cho mọi tác vụ của người dùng. Từ những câu chào hỏi xã giao đơn giản như "Hôm nay công ty có mở cửa không?", phân loại hóa đơn cơ bản, cho đến các truy vấn đòi hỏi suy luận logic 10 bước phức tạp về dòng tiền tài chính – tất cả đều được nạp chung vào một mô hình khổng lồ đắt đỏ.
Theo các nghiên cứu thực nghiệm hạ tầng AI năm 2026:
- 65% - 75% khối lượng công việc hàng ngày của một trợ lý số doanh nghiệp thực chất là các tác vụ định tuyến, phân loại hoặc trích xuất dữ liệu có cấu trúc đơn giản, hoàn toàn không đòi hỏi tư duy suy luận sâu (deep reasoning).
- Việc sử dụng các Frontier Reasoning Models cho các tác vụ cấp thấp gây ra sự lãng phí ngân sách từ 5 đến 20 lần trên mỗi triệu token xử lý, đồng thời kéo độ trễ (latency) từ 80ms lên hơn 3.000ms, hủy hoại trải nghiệm tương tác thời gian thực của khách hàng.
- Sự phụ thuộc cứng vào một nhà cung cấp độc quyền (Vendor Lock-in) khiến toàn bộ quy trình vận hành tê liệt khi xảy ra sự cố nghẽn mạng, tăng giá API đột ngột hoặc chạm trần giới hạn tần suất (HTTP 429 Rate Limit).
Chính vì vậy, kiến trúc AI Gateway tích hợp bộ điều hướng thông minh (Model Router) đã trở thành trung tâm điều khiển tối cao trong hạ tầng công nghệ năm 2026.
2. Giải Mã Bản Chất: Dynamic Model Routing & Cascading Inference Là Gì?
Để xây dựng một hệ thống AI thích ứng linh hoạt, doanh nghiệp cần phân biệt và kết hợp nhuần nhuyễn hai cơ chế trụ cột:
A. Dynamic Model Routing (Điều Hướng Mô Hình Động)
Đây là kỹ thuật đánh giá đặc tính của prompt ngay tại cửa ngõ tiếp nhận (Gateway Layer) trước khi gửi đi suy luận. Bộ định tuyến (Router) phân tích các yếu tố: độ phức tạp ngữ nghĩa, mục tiêu tác vụ, độ nhạy cảm của dữ liệu (PII) và ngân sách thời gian thực để chọn ra mô hình hoàn hảo nhất:
- Semantic Routing: Dựa vào không gian vector (embedding) để phân nhóm ý định. Ví dụ: yêu cầu sinh mã nguồn chuyên sâu được chuyển tới Claude hoặc Qwen-Coder; tác vụ dịch thuật đa ngữ chuyển tới mô hình chuyên biệt ngôn ngữ; yêu cầu tra cứu nội bộ chuyển sang SLM kết hợp Vector DB cục bộ.
- Complexity-Classifier Routing: Sử dụng một bộ phân loại siêu nhỏ (chạy trong dưới 10ms) để ước tính độ khó nhận thức của câu hỏi (Intent Difficulty Index). Nếu là câu hỏi định danh cơ bản → gửi tới mô hình 8B siêu tốc; nếu là bài toán logic trừu tượng → điều hướng thẳng tới mô hình reasoning cao cấp.
B. Cascading Inference (Suy Luận Phân Tầng Có Cổng Kiểm Duyệt)
Khác với Routing rẽ nhánh một lần, Cascading Inference là một chu trình bậc thang tối ưu chi phí cực đoan. Hệ thống mặc định trao cơ hội xử lý đầu tiên cho mô hình rẻ nhất (như SLM chạy trên NPU nội bộ hoặc mô hình giá rẻ dưới 0.1 USD/triệu token). Sau khi nhận phản hồi, một Cổng kiểm duyệt chất lượng (Quality Gate) sẽ lập tức đánh giá:
- Kiểm tra định dạng (Schema & Syntax Validation): Kết quả JSON/Function Call có hợp lệ 100% hay không?
- Chỉ số tự tin (Confidence Score & Logprobs): Mức độ chắc chắn của mô hình có vượt qua ngưỡng an toàn (ví dụ: > 92%)?
- Cơ chế Thẩm định (Judge-on-the-fly): Nếu không đạt chuẩn, hệ thống tự động kích hoạt bậc thang kế tiếp, chuyển ngữ cảnh và truy vấn sang mô hình mạnh hơn (Escalation Path) mà người dùng cuối hoàn toàn không nhận thấy sự gián đoạn.
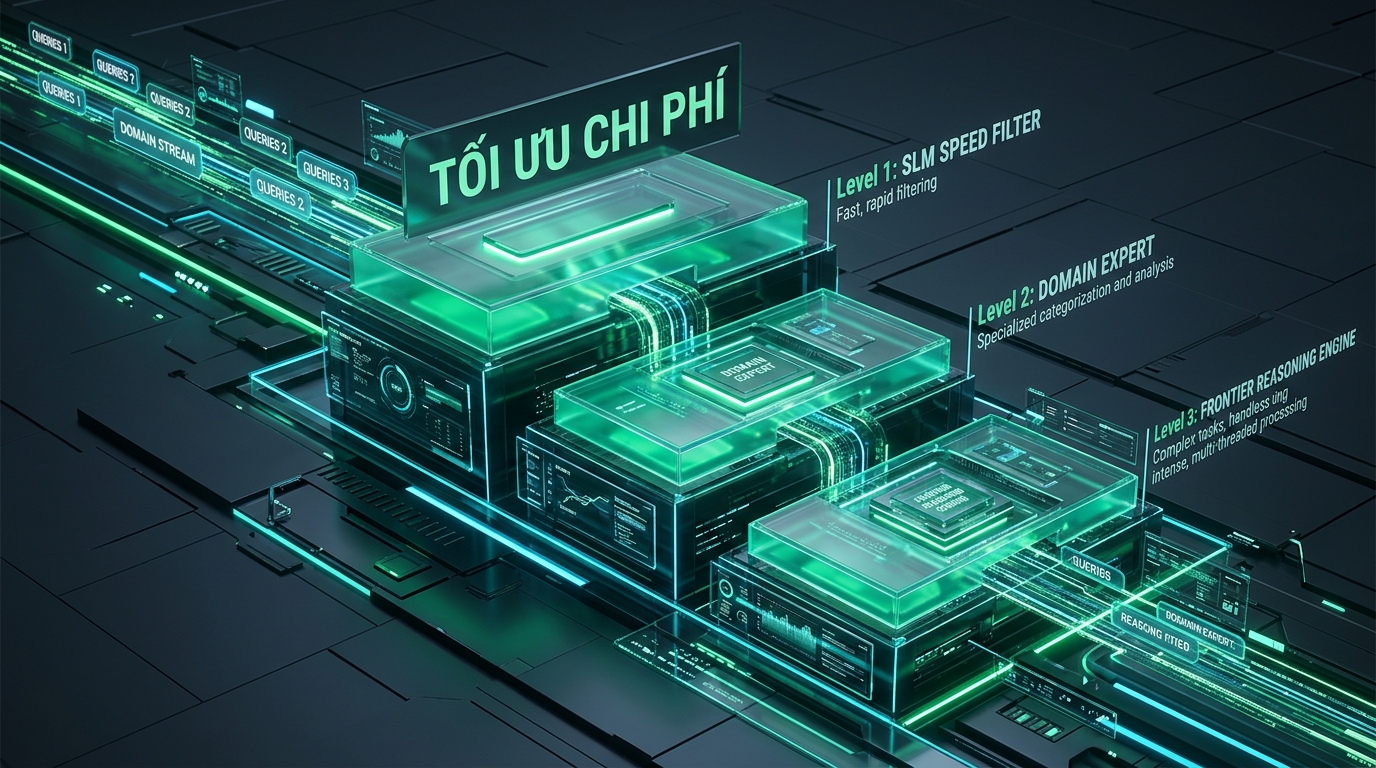 Sơ đồ cơ chế Cascading Inference đa tầng kết hợp Quality Gates giúp doanh nghiệp sàng lọc đến 80% tác vụ ở tầng siêu rẻ trước khi phải leo thang lên tầng Frontier đắt đỏ.
3. Lợi Ích Vượt Bậc Dành Cho Doanh Nghiệp Trong Kỷ Nguyên 2026
Cắt Giảm Đến 70% Chi Phí Hóa Đơn AI
Bằng việc định tuyến 70% các truy vấn thông thường sang các mô hình mã nguồn mở tinh gọn hoặc mô hình SLM thế hệ mới (như Llama 3.3, Phi-4, Gemma 12B), doanh nghiệp giải phóng hàng chục ngàn USD tiền API token mỗi tháng.
Độ Trễ Phản Hồi Giảm Xuống Dưới 150ms
Các tác vụ đơn giản không còn phải chờ đợi hàng giây trong hàng đợi của các siêu mô hình đám mây. Trải nghiệm người dùng đạt chuẩn phản hồi tức thì của các ứng dụng thương mại điện tử và dịch vụ khách hàng 2026.
Khả Năng Chống Chịu Sự Cố (High Availability)
Khi OpenAI, Anthropic hoặc Google gặp sự cố gián đoạn hay nghẽn mạng cục bộ, AI Gateway tự động chuyển hướng lưu lượng (Automatic Failover) sang nhà cung cấp dự phòng chỉ trong vài mili-giây, đảm bảo SLA 99.99% không gián đoạn.
Tuân Thủ Chủ Quyền Dữ Liệu & Bảo Mật PII
Bộ định tuyến tự động phát hiện các trường dữ liệu định danh cá nhân hoặc thông tin tài chính nhạy cảm để giữ lại xử lý tại máy chủ on-premise nội bộ, đáp ứng tiêu chuẩn EU AI Act và các quy định bảo mật khắt khe nhất.
4. Lộ Trình 4 Bước Triển Khai Kiến Trúc Dynamic Routing Cho Doanh Nghiệp
Để tích hợp cơ chế điều hướng thông minh vào sản phẩm thực tế mà không cần đập đi xây lại toàn bộ hệ thống, doanh nghiệp nên tuân thủ lộ trình chuẩn hóa sau:
-
Bước 1: Triển khai Lớp Đệm AI Gateway Trung Gian:
Thay vì gọi trực tiếp SDK của từng hãng trong mã nguồn ứng dụng, hãy thiết lập một AI Gateway chuẩn hóa (như LiteLLM Proxy, Bifrost hoặc Kong AI Gateway). Mọi dịch vụ nội bộ chỉ cần giao tiếp với một endpoint duy nhất tuân theo chuẩn OpenAI-compatible. -
Bước 2: Phân Tích Dữ Liệu Lịch Sử & Phân Cụm Tác Vụ:
Ghi nhật ký (Audit Logs) 10.000 truy vấn gần nhất để phân tích: Tỷ lệ câu hỏi đơn giản là bao nhiêu? Những loại câu hỏi nào thường xuyên gây ảo giác (hallucination) nếu dùng mô hình nhỏ? Từ đó thiết lập ma trận phân loại độ khó. -
Bước 3: Thiết Lập Ma Trận Điều Hướng & Cổng Kiểm Duyệt:
Cấu hình quy tắc phân tầng:Tier 1: Fast SLM (Local / Cheaper Cloud) → Verify Pydantic Output & Confidence
└ NẾU HỢP LỆ: Hoàn tất phản hồi (Tiết kiệm 85% chi phí)
└ NẾU LỖI HOẶC CONFIDENCE < 0.85: Tự động Escalate lên Tier 2
Tier 2: Mid-range General Model (Xử lý các logic tiêu chuẩn)
Tier 3: Frontier Reasoning Engine (Chuyên trị các bài toán kiến trúc, tài chính, đa bước phức tạp) -
Bước 4: Đánh Giá Liên Tục Bằng Evals (Evaluation Loops):
Tuyệt đối không đo lường router chỉ bằng con số chi phí tiết kiệm được. Hãy áp dụng hệ thống Evals tự động (như Braintrust hoặc DeepEval) lấy mẫu ngẫu nhiên 5% câu trả lời để chấm điểm chất lượng độc lập, đảm bảo tỷ lệ hài lòng của người dùng không hề suy giảm.
Kết luận: Năm 2026 không còn là cuộc đua xem ai sở hữu mô hình AI to nhất, mà là cuộc đua xem ai biết sử dụng đúng mô hình cho đúng việc vào đúng thời điểm. Dynamic Model Routing và Cascading Inference không chỉ là giải pháp kỹ thuật tối ưu chi phí, mà chính là nền tảng sống còn giúp doanh nghiệp vận hành các đội quân nhân viên số tự trị quy mô lớn một cách bền vững, an toàn và tối đa hóa lợi nhuận đầu tư (ROI).