
Trong suốt gần một thập kỷ thống trị của kiến trúc Transformer, mọi mô hình trí tuệ nhân tạo đều vận hành dựa trên một nguyên lý bất di bất dịch: mọi token dữ liệu – dù là một dấu phẩy đơn giản hay một suy luận logic đa tầng phức tạp – đều phải đi qua chính xác số lượng lớp tính toán (layers) như nhau. Bước sang năm 2026, khi chi phí hạ tầng GPU chạm ngưỡng báo động và yêu cầu suy luận thời gian thực bùng nổ, kiến trúc Mixture of Depths (MoD) ra đời như một cuộc cách mạng giải phóng tài nguyên tính toán, cho phép mô hình AI tự quyết định độ sâu suy luận cho từng token, tăng gấp đôi tốc độ inference mà không làm suy giảm trí thông minh vốn có.
Nghịch Lý Tính Toán Cào Bằng Của Transformer Truyền Thống
Để thấu hiểu bước nhảy vọt của MoD, trước tiên cần nhìn thẳng vào "nỗi đau" lớn nhất của các mô hình ngôn ngữ lớn (LLM) hiện nay: tính toán cào bằng (uniform computation). Trong một chuỗi văn bản, không phải mọi từ ngữ đều mang giá trị thông tin tương đương:
- Các token ngữ cảnh thấp: Các từ nối, mạo từ hay khoảng trắng như "là", "và", "của", "the", "in" thường có độ bất định cực thấp và chỉ cần 1–2 tầng tính toán đầu tiên để xác định ngữ nghĩa.
- Các token suy luận cao: Những từ khóa quan trọng, các số liệu tài chính hoặc logic giải toán đòi hỏi sự chú ý sâu sắc qua hàng chục tầng Self-Attention và Feed-Forward Networks (FFN).
Việc ép buộc 100% token phải duyệt qua 100% số tầng mạng nơ-ron khiến các trung tâm dữ liệu AI của doanh nghiệp lãng phí từ 40% đến 60% chỉ số FLOPs (Floating-point Operations). Điều này dẫn tới hóa đơn tiền điện khổng lồ, thời gian phản hồi (Time-to-First-Token) kéo dài và nghẽn băng thông nghiêm trọng trong các hệ thống phục vụ hàng triệu người dùng đồng thời.
Giải Mã Mixture of Depths (MoD): Tính Toán Động Theo Chiều Sâu
Được tiên phong nghiên cứu bởi các kỹ sư hàng đầu và hoàn thiện vào năm 2026, Mixture of Depths (MoD) tái cấu trúc cách thức thông tin luân chuyển trong mạng nơ-ron bằng cơ chế phân bổ tính toán động (Dynamic Compute Allocation):
1. Bộ Định Tuyến Chiều Sâu (Top-k Depth Router)
Tại mỗi khối tính toán (gồm Self-Attention hoặc MLP), một bộ định tuyến tuyến tính siêu nhẹ (Router) sẽ chấm điểm tầm quan trọng của từng token trong ngữ cảnh hiện tại. Mô hình chỉ chọn ra top-k token có điểm số cao nhất để thực hiện phép tính đầy đủ. Các token còn lại sẽ được đưa thẳng qua đường dẫn tắt (Residual Connection) mà không tiêu tốn thêm chu kỳ tính toán nào.
2. Ngân Sách Tính Toán Tĩnh (Static Compute Budget)
Khác với những nỗ lực tính toán có điều kiện (Conditional Computation) trước đây vốn gây ra sự biến động kích thước ma trận và làm treo phần cứng GPU, MoD thiết lập một ngân sách tĩnh cố định trước. Số lượng token k được xử lý tại mỗi tầng luôn bất biến, giúp kích thước tensor hoàn toàn đồng nhất. Nhờ đó, các GPU/NPU chuyên dụng có thể tối ưu hóa bộ nhớ đệm (Cache Line) và đạt hiệu suất phần cứng (MFU - Model FLOPs Utilization) tiệm cận mức tối đa.
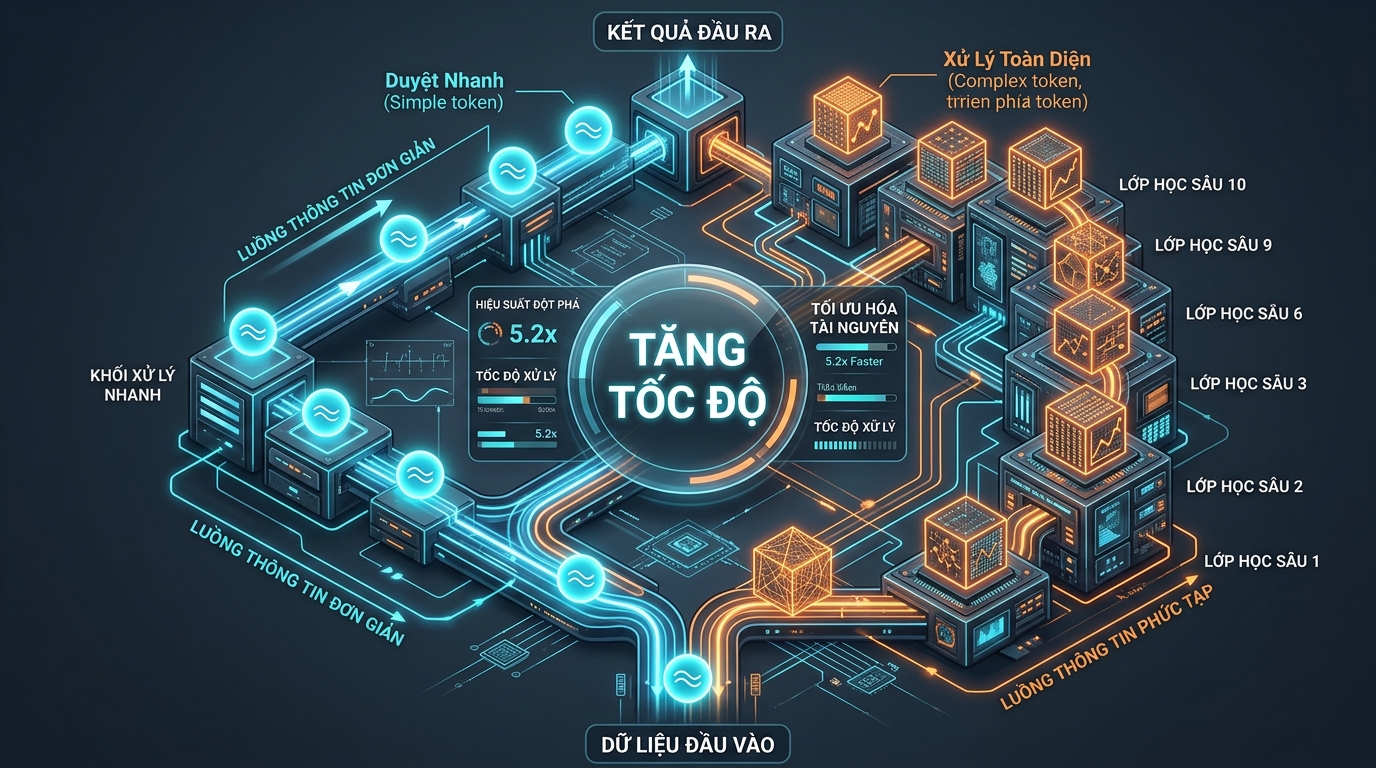 Sơ đồ luồng xử lý của Mixture of Depths: Phân luồng token đơn giản đi tắt qua Residual Path và tập trung tài nguyên tính toán sâu cho các token suy luận phức tạp.
MoD vs. MoE: Cuộc Cách Mạng Chiều Sâu Đối Đầu Chiều Rộng
Nhiều nhà phát triển thường nhầm lẫn giữa Mixture of Experts (MoE) và Mixture of Depths (MoD). Về mặt bản chất, đây là hai chiều không gian bổ trợ nhau:
- Mixture of Experts (MoE - Định tuyến theo chiều rộng): Phân chia tầng FFN thành nhiều chuyên gia (Experts). Với mỗi token, mô hình chọn ra 1-2 chuyên gia phù hợp nhất. MoE mở rộng dung lượng tham số (Parameter Capacity) mà không tăng FLOPs, nhưng đòi hỏi dung lượng VRAM rất lớn để lưu toàn bộ các chuyên gia.
- Mixture of Depths (MoD - Định tuyến theo chiều sâu): Giữ nguyên dung lượng mô hình nhưng linh hoạt quyết định token nào được đi sâu vào tầng tính toán. MoD trực tiếp giảm thiểu FLOPs thực thi và giảm tải áp lực băng thông bộ nhớ.
- Kiến trúc lai MoDE (MoE + MoD) 2026: Đỉnh cao kiến trúc hiện tại kết hợp cả hai: phân chia chuyên gia theo chiều ngang và cắt tỉa tầng theo chiều dọc. Kết quả là những mô hình có sức mạnh tương đương 70B tham số nhưng vận hành với chi phí và tốc độ của một mô hình 8B!
Giá Trị Thực Tiễn Cho Doanh Nghiệp: Tăng 2 Lần Throughput, Tiết Kiệm Hàng Triệu USD
Đối với các tổ chức và doanh nghiệp đang vận hành hệ thống AI phục vụ sản xuất thương mại, việc chuyển đổi sang kiến trúc MoD mang lại những lợi ích đo lường được ngay lập tức:
- Cắt giảm 50% chi phí điện toán đám mây: Vì chỉ có khoảng 50% số token cần tính toán đầy đủ ở các tầng trung gian, tổng lượng FLOPs tiêu thụ trên mỗi yêu cầu giảm một nửa, giúp doanh nghiệp tiết kiệm 40–50% chi phí thuê cụm máy chủ GPU.
- Tăng gấp đôi thông lượng phục vụ (Inference Throughput): Với cùng một hạ tầng máy chủ sẵn có, hệ thống có thể xử lý lượng người dùng đồng thời gấp đôi mà không gặp hiện tượng tràn hàng đợi (Queue Overflow).
- Đột phá cho Real-time Voice và Interactive Agents: Đối với các ứng dụng trợ lý giọng nói đàm thoại tức thì (Native Voice) hay Agent điều khiển giao diện đòi hỏi độ trễ dưới 200ms, khả năng bỏ qua các phép tính dư thừa của MoD chính là chìa khóa then chốt để đạt trải nghiệm mượt mà không độ trễ.
- Độ chính xác tương đương (IsoFLOP Parity): Các bài kiểm thử benchmark toàn diện năm 2026 chứng minh rằng mô hình huấn luyện với MoD đạt độ chính xác tương đương hoặc thậm chí vượt trội hơn mô hình Transformer truyền thống khi được chuẩn hóa trên cùng một mức ngân sách tính toán.
Lộ Trình 4 Bước Cho Doanh Nghiệp Đón Đầu Làn Sóng MoD
Để hiện thực hóa tiềm năng của Mixture of Depths vào hạ tầng công nghệ năm 2026, các nhà quản lý công nghệ (CTO) và kỹ sư AI cần triển khai theo lộ trình sau:
- Bước 1 - Rà soát hồ sơ độ trễ (Latency Profiling): Phân loại các tác vụ AI thành nhóm nhạy cảm với độ trễ (như chatbot chăm sóc khách hàng, phân loại email) và nhóm cần suy luận sâu (phân tích báo cáo tài chính, thẩm định pháp lý).
- Bước 2 - Triển khai MoD trên các mô hình On-Premise SLM: Tận dụng các mô hình nhỏ chuyên biệt (Small Language Models) tích hợp sẵn MoD để chạy cục bộ trên máy chủ doanh nghiệp hoặc thiết bị Edge mà không cần đầu tư dàn GPU đắt đỏ.
- Bước 3 - Nâng cấp Inference Engine: Cập nhật các runtime engine suy luận hỗ trợ Dynamic Routing và Static Tensor Graph như vLLM 2026, TensorRT-LLM phiên bản mới nhất để kích hoạt khả năng tăng tốc của MoD.
- Bước 4 - Giám sát tỷ lệ tham gia của Token (Layer Participation Ratio): Thiết lập dashboard quan sát (Observability) để theo dõi hành vi định tuyến của mô hình, đảm bảo các tri thức cốt lõi của doanh nghiệp luôn được xử lý tại các tầng tính toán chuyên sâu nhất.
Kết luận: Thời kỳ của việc "đốt tiền" vào những phép tính cào bằng vô nghĩa trên các mô hình AI cồng kềnh đã khép lại. Mixture of Depths (MoD) mở ra kỷ nguyên của sự thanh thoát, hiệu quả và trí tuệ có chọn lọc. Những doanh nghiệp sớm làm chủ kiến trúc điện toán linh hoạt này trong năm 2026 sẽ nắm giữ lợi thế cạnh tranh áp đảo về chi phí vận hành và tốc độ phụng sự khách hàng trong nền kinh tế số.