
Trong làn sóng chuyển mình của trí tuệ nhân tạo năm 2026, điểm nghẽn lớn nhất ngăn cản AI thâm nhập sâu vào các nghiệp vụ cốt lõi của doanh nghiệp không còn là dung lượng ngữ cảnh hay tốc độ sinh token, mà là "hội chứng ảo giác tích lũy" (compounding hallucination). Khắc phục triệt để hạn chế của các mô hình thưởng kết quả truyền thống (Outcome Reward Models - ORM), sự trỗi dậy của Process Reward Models (PRMs) kết hợp cùng cơ chế giám sát từng bước (Process Supervision) đang trở thành "bộ lọc tư duy" tiêu chuẩn, mở ra kỷ nguyên suy luận minh bạch và chuẩn xác chưa từng có cho các hệ thống AI Agent doanh nghiệp.
1. Khủng Hoảng Của Mô Hình Thưởng Kết Quả (ORM) Và Nỗi Ám Ảnh "Đúng Đáp Án, Sai Bản Chất"
Suốt nhiều năm qua, phương pháp học tăng cường từ phản hồi của con người (RLHF) chủ yếu dựa vào các mô hình Outcome Reward Models (ORMs). Cách tiếp cận này tương tự như một giám khảo chỉ nhìn vào đáp số cuối cùng của bài toán lớp 12: nếu kết quả đúng, mô hình được thưởng; nếu kết quả sai, mô hình bị phạt.
Tuy nhiên, trong môi trường vận hành doanh nghiệp phức tạp—nơi một quyết định kinh doanh, bản phân tích rủi ro tài chính hay hợp đồng pháp lý bao gồm hàng chục mắt xích suy luận—ORM bộc lộ hai lỗ hổng chí mạng:
- Ảo giác tích lũy (Compounding Errors): Một sai sót nhỏ về số liệu hoặc giả định logic ở Bước 2 sẽ lan truyền và khuếch đại qua các bước tiếp theo, khiến toàn bộ chuỗi suy luận sụp đổ dù giọng văn phản hồi của AI vẫn vô cùng tự tin và mạch lạc.
- Đúng ngẫu nhiên nhờ sai sót bù trừ (Spurious Reasoning): Mô hình có thể đưa ra các lập luận hoàn toàn sai lệch ở giữa chuỗi, nhưng do ngẫu nhiên lại ra kết quả cuối cùng khớp với mong đợi, khiến ORM tiếp tục "dung túng" và củng cố thói quen tư duy sai lệch của AI.
Khi AI được trao quyền tự trị (Autonomous Agents) để ra quyết định mua hàng, cấp tín dụng hoặc kiểm toán số sách trong năm 2026, các doanh nghiệp không thể mạo hiểm đặt cược tài sản vào một "hộp đen may rủi" như vậy.
2. Process Reward Models (PRM): Giải Mã "Kính Hiển Vi" Soi Từng Bước Suy Luận
Thay vì đợi đến khi mô hình hoàn tất toàn bộ câu trả lời mới tiến hành đánh giá, Process Reward Models (PRMs) phân rã chuỗi tư duy (Chain-of-Thought - CoT) thành từng bước suy luận nguyên tử (Atomic Reasoning Steps) và lập tức chấm điểm độ tin cậy cho từng mắt xích đó.
Sự Kết Hợp Cùng Monte Carlo Tree Search (MCTS)
Đột phá thực sự của năm 2026 xuất hiện khi PRM được tích hợp trực tiếp vào các thuật toán tìm kiếm không gian suy luận thời gian thực như Monte Carlo Tree Search (MCTS) hoặc Beam Search trong quá trình suy luận (Test-Time Compute). Thay vì chỉ suy nghĩ theo một đường thẳng duy nhất, hệ thống AI vận hành như một đại kiện tướng cờ vua:
- Phát hiện và cắt tỉa tức thì (Early Pruning): Ngay khi PRM phát hiện một bước suy luận có điểm số dưới ngưỡng an toàn (ví dụ: trích dẫn sai điều khoản pháp lý hoặc nhầm lẫn công thức khấu hao), nhánh tư duy đó sẽ bị triệt tiêu ngay lập tức mà không làm lãng phí token tính toán.
- Khám phá đa lộ trình tối ưu (Optimal Path Exploration): Hệ thống tự động quay lui (backtracking) và mở rộng các nhánh tư duy có điểm xác thực cao nhất, đảm bảo chuỗi lập luận cuối cùng đạt độ tiệm cận hoàn hảo.
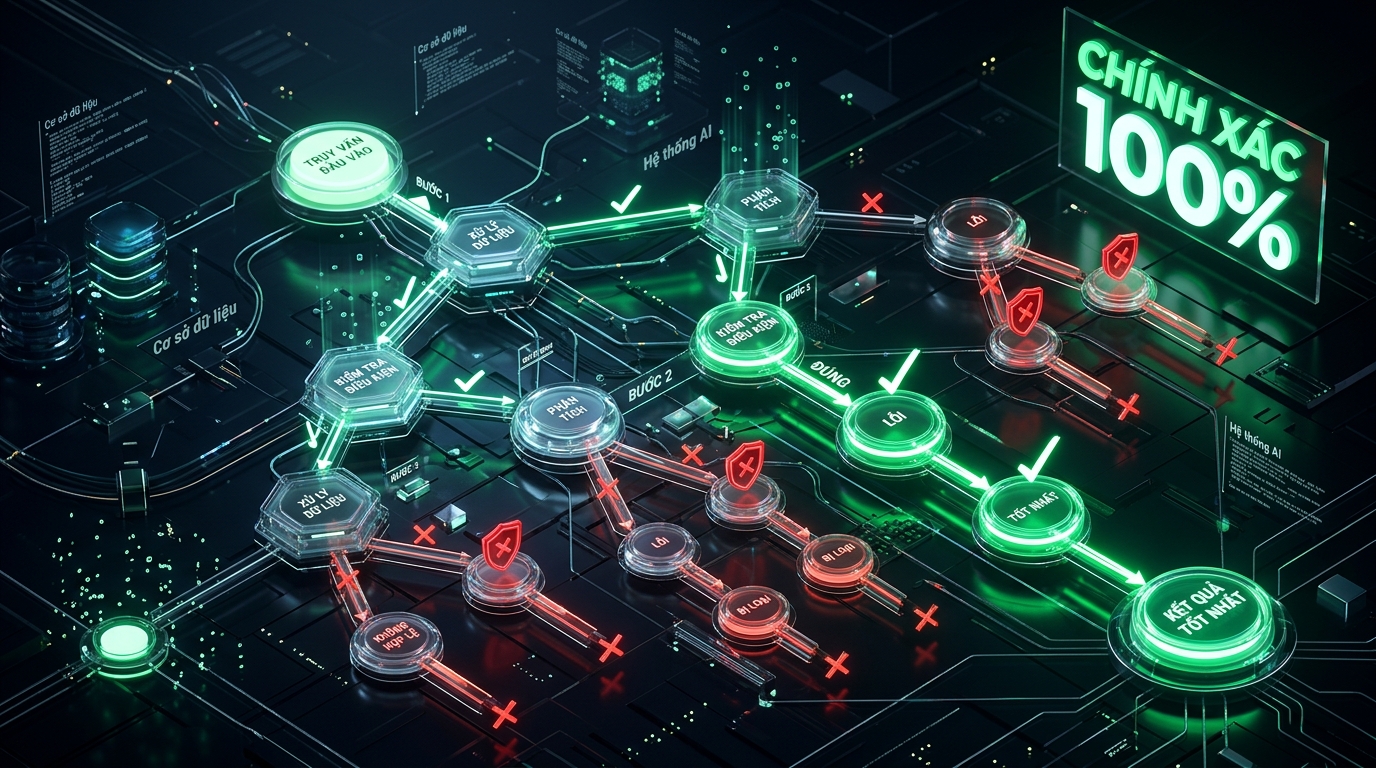
Minh họa quy trình PRM chấm điểm từng bước suy luận: Các nhánh tư duy sai lệch bị cô lập và cắt tỉa kịp thời, giữ lại duy nhất lộ trình logic đạt độ chuẩn xác 100%.
Từ Discriminative PRM Đến Generative ThinkPRM
Năm 2026 cũng chứng kiến bước nhảy vọt từ các bộ phân loại nhị phân đơn giản (Discriminative PRMs chỉ xuất ra điểm số 0 hoặc 1) sang Generative PRMs (như ThinkPRM, ReasonFlux-PRM). Các mô hình giám sát thế hệ mới này không chỉ chấm điểm mà còn tự sinh ra chuỗi lập luận phản biện chi tiết, giải thích rõ lý do tại sao một bước tính toán bị coi là sai sót và gợi ý hướng điều chỉnh cho mô hình thực thi.
3. AgentPRM: Tấm Khiên Chống Đột Biến Cho Nhân Viên Số Doanh Nghiệp
Khi AI bước vào giai đoạn thực thi các tác vụ thực tế (Agentic Workflows) như tương tác API ngân hàng, sửa đổi mã nguồn phần mềm hoặc cấu hình máy chủ đám mây, sai lầm không còn dừng lại ở một câu trả lời văn bản sai mà có thể gây tê liệt toàn bộ hệ thống vận hành. Đây chính là lúc AgentPRM phát huy vai trò phòng thủ cốt tử:
- Xác thực trước khi hành động (Pre-Execution Gatekeeping): Trước khi Agent bấm nút gửi một câu lệnh SQL
UPDATEhoặc kích hoạt lệnh chuyển tiền API, AgentPRM đánh giá tính hợp lệ của tham số, quyền hạn và tính logic của hành động so với mục tiêu ban đầu của người dùng. - Vô hiệu hóa tấn công Prompt Injection gián tiếp: Nếu dữ liệu đầu vào chứa các câu lệnh độc hại ngầm (Hidden Prompt Injections), PRM sẽ phát hiện bước suy luận bị bẻ cong lệch khỏi quy trình tiêu chuẩn và lập tức ngắt chuỗi thực thi, kích hoạt cảnh báo an ninh cho quản trị viên.
- Giải quyết bài toán "Quá tải bồi thường" (Overcredit Mitigation): Nhờ áp dụng hàm mất mát Overcredit Contrastive (OC loss), AgentPRM không bao giờ trao điểm cao cho các bước thực thi thành công nếu bước đó xuất phát từ tiền đề suy luận sai trái.
4. Tác Động Kinh Tế: Nghịch Lý Mô Hình Nhỏ Đánh Bại Siêu Mô Hình
Sự phổ cập của Process Reward Models trong năm 2026 đang làm đảo lộn hoàn toàn tư duy đầu tư công nghệ của các nhà lãnh đạo doanh nghiệp:
- Sức mạnh của Test-Time Compute: Thay vì phải trả chi phí khổng lồ cho các siêu mô hình nghìn tỷ tham số (Trillion-parameter models), doanh nghiệp có thể triển khai các mô hình mã nguồn mở cỡ trung (14B đến 32B tham số) kết hợp cùng một PRM giám sát chuyên biệt. Khi cho phép mô hình suy nghĩ lâu hơn thông qua cây tìm kiếm MCTS, độ chính xác trong giải quyết bài toán phức tạp vượt xa mô hình lớn chạy ở chế độ sinh từ ngẫu nhiên.
- Cắt giảm từ 60% đến 80% chi phí sửa sai: Chi phí sửa chữa một lỗi nghiệp vụ do AI gây ra sau khi đã ghi vào cơ sở dữ liệu đắt gấp hàng trăm lần chi phí thêm vài chục token suy luận để PRM kiểm chứng từng bước ngay từ đầu.
- Khả năng giải trình tuân thủ (Auditability): Cây suy luận đã được PRM gắn nhãn cung cấp một nhật ký kiểm toán (audit log) minh bạch 100%, đáp ứng trọn vẹn các tiêu chuẩn khắt khe của Đạo luật EU AI Act và quy định bảo vệ dữ liệu tài chính toàn cầu.
5. Lộ Trình 4 Bước Triển Khai Process Supervision Cho Doanh Nghiệp
Để đưa công nghệ giám sát quy trình vào hệ thống vận hành thực tế mà không đòi hỏi đội ngũ nghiên cứu khổng lồ, các nhà phát triển và doanh nghiệp có thể áp dụng lộ trình 4 bước tinh gọn:
- Chuẩn hóa chuỗi tác vụ thành các bước nguyên tử: Phân rã quy trình công việc phức tạp thành các trạng thái rõ ràng (State Transitions): Thu thập dữ liệu → Kiểm tra tính hợp lệ → Tính toán trung gian → Ra quyết định sơ bộ → Kích hoạt hành động.
- Thiết lập bộ kiểm chứng lai (Hybrid Verifiers): Kết hợp giữa các quy tắc logic cứng (Heuristic / Deterministic checks như schema validation, regex, SQL linter) và một mô hình SLM đóng vai trò PRM để chấm điểm tính nhất quán ngữ nghĩa của từng bước.
- Áp dụng cơ chế Best-of-N có hướng dẫn (Reward-Guided Sampling): Với mỗi bước quan trọng, cho phép Agent sinh ra 3-5 nhánh lựa chọn hành động, sau đó sử dụng PRM để chọn nhánh có điểm tín nhiệm cao nhất trước khi bước sang giai đoạn tiếp theo.
- Khép kín vòng lặp dữ liệu giám sát (Closed-Loop Flywheel): Lưu vết các chuỗi suy luận thất bại và thành công vào kho dữ liệu nội bộ để liên tục tinh chỉnh (fine-tune) mô hình PRM riêng của doanh nghiệp bằng kỹ thuật Direct Preference Optimization (DPO) hoặc Monte Carlo Information Gain.
Kết luận: Kỷ nguyên đánh giá AI dựa trên kết quả bề nổi đã khép lại. Năm 2026 đánh dấu cột mốc mà năng lực cạnh tranh cốt lõi của một hệ thống AI doanh nghiệp không nằm ở việc nó trả lời nhanh hay chậm, mà nằm ở mức độ kỷ luật và tính minh bạch trong từng bước suy luận. Làm chủ Process Reward Models và cơ chế Process Supervision chính là chiếc chìa khóa vàng giúp doanh nghiệp xóa bỏ hoàn toàn rào cản ảo giác, tự tin đưa AI tự trị vào vận hành các sứ mệnh sống còn.