
Bước sang năm 2026, khi các hệ sinh thái Trí tuệ Nhân tạo dịch chuyển mạnh mẽ từ các chatbot đối thoại đơn giản sang AI Agent tự trị (Autonomous Agents) và các mô hình suy luận đa bước (Reasoning Models), một bài toán hóc búa bậc nhất đang đè nặng lên vai các nhà lãnh đạo công nghệ: Làm thế nào để phục vụ các mô hình ngôn ngữ lớn (LLM) với tốc độ tức thì mà không khiến ngân sách điện toán đám mây bị thiêu rụi? Câu trả lời mang tính cách mạng cho năm 2026 chính là Speculative Decoding (Giải mã suy đoán) – kỹ thuật đột phá giúp tăng tốc độ sinh token từ 3x đến 4.5x hoàn toàn lossless và cắt giảm tới 70% chi phí hạ tầng máy chủ GPU.
Bế Tắc Băng Thông Bộ Nhớ: Nỗi Ám Ảnh Của Hạ Tầng AI Doanh Nghiệp
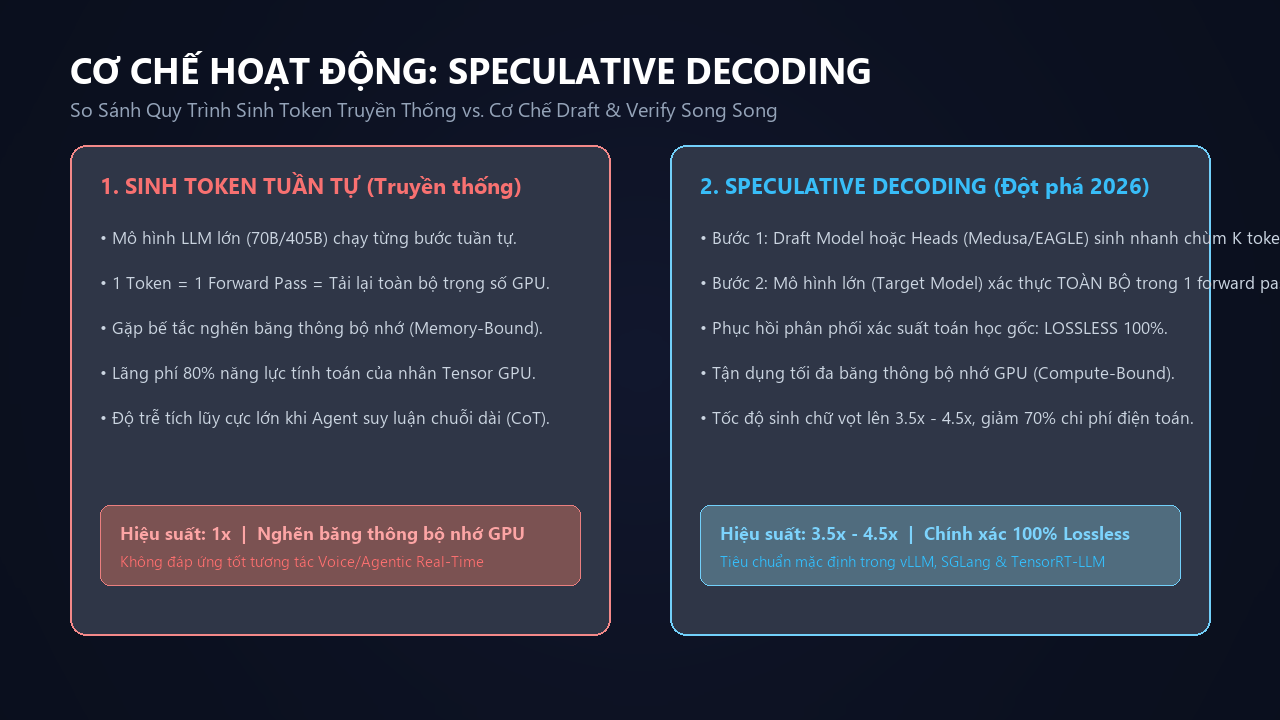
Trong suốt nhiều năm qua, quy trình sinh văn bản của các mô hình Transformer dựa trên cơ chế Auto-regressive (Tự hồi quy) tuần tự: để sinh ra một từ (token) mới, mô hình phải nhận toàn bộ các từ trước đó làm đầu vào và thực hiện một lượt tính toán chuyển tiếp (forward pass). Điều này dẫn đến một nghịch lý cay đắng trong khoa học máy tính: Điểm nghẽn không nằm ở tốc độ tính toán (FLOPs) của chip, mà nằm ở băng thông bộ nhớ (Memory Bandwidth).
1. Tại sao LLM truyền thống lại chạy chậm và lãng phí GPU?
Khi doanh nghiệp vận hành một mô hình lớn như Llama-3 70B hoặc các mô hình 405B, việc sinh ra duy nhất một token đòi hỏi chip GPU phải tải toàn bộ hàng chục tới hàng trăm Gigabyte trọng số (weights) từ bộ nhớ HBM vào nhân xử lý Tensor Cores. Do quá trình này chỉ sinh ra đúng 1 token mỗi lần, nhân Tensor Core cực mạnh của các dòng GPU đầu bảng như H100 hay B200 phải nằm ở trạng thái "chờ dữ liệu" phần lớn thời gian (Memory-Bound).
- Hiệu suất sử dụng GPU dưới 20%: Khả năng tính toán số học bị lãng phí nghiêm trọng vì tốc độ đọc từ bộ nhớ HBM không theo kịp tốc độ xử lý của nhân Tensor.
- Độ trễ tích lũy khổng lồ (High Latency): Nếu một phản hồi cần 500 token, GPU buộc phải thực hiện 500 lượt đọc toàn bộ mô hình một cách tuần tự, khiến thời gian phản hồi kéo dài từ vài giây đến cả chục giây.
- Khủng hoảng chi phí token khi chạy Reasoning & Agentic: Các mô hình suy luận sâu (như chuỗi Chain-of-Thought) cần tự sinh hàng nghìn "token suy nghĩ" trước khi trả lời, làm tê liệt khả năng phục vụ diện rộng của doanh nghiệp.
Giải Mã Speculative Decoding: Cơ Chế "Dự Đoán Nhanh – Xác Thực Song Song"
Nguyên lý cốt lõi của Speculative Decoding dựa trên một quy luật thống kê kinh điển trong ngôn ngữ tự nhiên: Không phải mọi token đều đòi hỏi trí thông minh siêu việt để suy đoán. Các từ nối, giới từ, mạo từ hay những cấu trúc ngữ pháp thông dụng hoàn toàn có thể được phán đoán chính xác bởi những mô hình nhỏ gọn hoặc các đầu giải mã siêu nhẹ.
Vòng Lặp Hoạt Động 2 Bước: Draft & Verify
- Bước 1 - Phác thảo suy đoán (Draft Phase): Một mô hình nhỏ (Draft Model) hoặc các đầu giải mã phụ trợ cực nhanh sẽ suy đoán trước một chuỗi gồm $K$ token tiếp theo (ví dụ: 4 - 6 token) chỉ trong vài phần nghìn giây.
- Bước 2 - Xác thực song song (Verification Phase): Mô hình lớn mục tiêu (Target Model) sẽ nhận toàn bộ chuỗi $K$ token này và chạy kiểm tra tất cả cùng một lúc chỉ trong 1 forward pass duy nhất.
- Bước 3 - Chấp nhận và Sửa sai (Acceptance & Correction): Dựa trên phân phối xác suất toán học, mô hình lớn sẽ đồng ý với các token đúng và sửa ngay lập tức token đầu tiên bị sai. Nếu mô hình chấp nhận 4/5 token, tốc độ sinh chuỗi văn bản đã tăng gấp 4 lần so với cách chạy tuần tự truyền thống!
Điểm mấu chốt tạo nên kỳ tích công nghệ này là: Chi phí tính toán để GPU chạy 1 forward pass cho 5 token song song gần như tương đương với chi phí chạy 1 forward pass cho 1 token đơn lẻ, bởi vì toàn bộ trọng số mô hình chỉ cần nạp vào bộ nhớ đúng một lần.
Đảm Bảo Tuyệt Đối: Tính Toán Học "Lossless" 100%
Rất nhiều doanh nghiệp lo ngại việc dùng mô hình nhỏ để suy đoán sẽ làm giảm chất lượng đầu ra của AI. Tuy nhiên, các nhà nghiên cứu đã chứng minh bằng toán học rằng: Speculative Decoding là phương pháp gia tốc Lossless (Không suy hao) hoàn toàn. Nhờ thuật toán lấy mẫu hiệu chỉnh (Speculative Sampling), phân phối xác suất của văn bản đầu ra sau khi được mô hình lớn kiểm duyệt hoàn toàn trùng khớp 100% với việc để mô hình lớn tự sinh từ đầu. Trí thông minh, tính chặt chẽ và khả năng lập luận của LLM được bảo toàn nguyên vẹn.
Cuộc Cách Mạng Kiến Trúc 2026: Từ Draft Model Đến Medusa & EAGLE-3
Nếu như giai đoạn đầu của Speculative Decoding đòi hỏi phải duy trì hai mô hình riêng biệt (một mô hình nhỏ 1B-7B làm Draft và một mô hình lớn 70B làm Target – gây phức tạp trong quản lý VRAM), thì bước sang năm 2026, hai trường phái kiến trúc mới đã định hình lại tiêu chuẩn ngành:
1. Kiến Trúc Medusa: Đa Đầu Giải Mã Không Cần Model Phụ
Kiến trúc Medusa loại bỏ hoàn toàn mô hình Draft riêng biệt. Thay vào đó, các nhà phát triển gắn trực tiếp nhiều "đầu giải mã" (decoding heads) siêu nhẹ vào lớp cuối cùng của chính mô hình lớn.
- Medusa-1: Đóng băng trọng số cốt lõi của LLM và chỉ huấn luyện nhanh các đầu giải mã mới. Phương pháp này cực kỳ dễ triển khai và không can thiệp vào mô hình gốc.
- Medusa-2: Huấn luyện đồng thời các đầu giải mã cùng với việc tinh chỉnh nhẹ mô hình chính, mang lại tỷ lệ chấp nhận token (Acceptance Rate) vượt trội và đạt tốc độ gia tốc từ 2.5x đến 3.6x.
- Cây ứng viên (Tree Attention): Thay vì suy đoán theo một đường thẳng duy nhất, Medusa sinh ra một "cây các token tiềm năng", cho phép mô hình lớn kiểm tra đồng thời nhiều phương án khả thi trong một lần duyệt.
2. EAGLE-2 & EAGLE-3: Dự Đoán Cấp Độ Đặc Trưng (Feature-Level Extrapolation)
Được đánh giá là bước tiến mạnh mẽ nhất trong năm 2026, họ mô hình EAGLE (Extrapolation Algorithm for Greater Language-model Efficiency) giải quyết bài toán suy đoán không phải ở tầng từ vựng (token level) mà ở tầng không gian ẩn (hidden feature level):
- Độ chính xác vượt bậc: Việc dự đoán vector đặc trưng nội tại của mô hình giúp EAGLE nắm bắt ngữ cảnh sâu sắc hơn nhiều so với việc dự đoán từ ngữ bề mặt.
- Cây suy đoán động theo ngữ cảnh (Context-Aware Dynamic Tree): EAGLE-2 và EAGLE-3 tự động điều chỉnh cấu trúc cây suy đoán dựa trên độ tự tin của mô hình ở từng bước, nâng tốc độ thực tế lên mức 3.5x - 4.5x ngay cả trên các tác vụ lập trình (Coding) và toán học phức tạp.
Tác Động Sâu Sắc Đến Doanh Nghiệp Và Chiến Lược AI FinOps
Việc ứng dụng Speculative Decoding không đơn thuần là một cải tiến kỹ thuật trong phòng lab, mà là đòn bẩy tài chính và vận hành có tính sống còn cho các doanh nghiệp xây dựng sản phẩm dựa trên AI:
- Cắt giảm trực tiếp 60% – 70% hóa đơn GPU: Thay vì phải thuê 4 cụm máy chủ GPU H100 để đáp ứng lượng người dùng tăng cao, doanh nghiệp giờ đây chỉ cần duy trì 1 cụm máy chủ được kích hoạt Speculative Decoding mà vẫn đạt cùng mức thông lượng (Throughput).
- Mở khóa kỷ nguyên Voice AI & Real-Time Agents: Các trợ lý giọng nói và nhân viên số yêu cầu độ trễ tương tác dưới 300ms. Speculative Decoding loại bỏ độ trễ phản hồi ban đầu (Time to First Token) và tăng tốc độ đọc văn bản, mang lại trải nghiệm mượt mà không có quãng ngắt.
- Tối ưu hóa sâu sắc bài toán AI FinOps: Tỷ lệ token/giây trên mỗi USD đầu tư tăng vọt gấp 3 lần, giúp các dự án AI vượt qua giai đoạn thử nghiệm (PoC) để đi vào sản xuất thương mại với biên lợi nhuận lành mạnh.
Lộ Trình Triển Khai Thực Chiến Cho Đội Ngũ Công Nghệ
Để áp dụng ngay công nghệ này vào hệ thống của doanh nghiệp trong năm 2026, đội ngũ kỹ thuật có thể thực hiện theo các bước tinh gọn sau:
- Tận dụng các Inference Engine thế hệ mới: Hiện nay các công cụ phục vụ suy luận hàng đầu như
vLLM,SGLangvàTensorRT-LLMđều đã tích hợp sẵn hỗ trợ Speculative Decoding, Medusa và EAGLE. Chỉ cần bổ sung cờ cấu hình (flags) khi khởi động server mà không cần sửa đổi mã nguồn ứng dụng. - Thiết lập giám sát Tỷ lệ Chấp nhận (Acceptance Rate): Tỷ lệ này phản ánh phần trăm số token suy đoán được mô hình lớn chấp nhận (mức lý tưởng là từ 65% - 85%). Nếu tỷ lệ này giảm xuống dưới 50% trên một miền nghiệp vụ chuyên biệt, cần tinh chỉnh lại Draft Model hoặc các đầu Medusa trên tập dữ liệu đặc thù của doanh nghiệp.
- Cân bằng giữa Kích thước Batch và Bộ nhớ VRAM: Speculative Decoding đạt hiệu năng thần tốc nhất ở kịch bản phục vụ thời gian thực (Batch size nhỏ hoặc Streaming). Với các tác vụ xử lý hàng loạt khối lượng lớn (High batch), cần tính toán phân bổ bộ nhớ KV Cache hợp lý để tránh tràn VRAM.
Kết luận: Trong cuộc đua AI năm 2026, lợi thế cạnh tranh không chỉ nằm ở việc sở hữu mô hình thông minh nhất, mà nằm ở việc ai có thể vận hành mô hình đó nhanh nhất với chi phí tiết kiệm nhất. Speculative Decoding chính là chiếc chìa khóa vàng giúp doanh nghiệp phá vỡ rào cản băng thông phần cứng, biến trí tuệ nhân tạo từ một chi phí đắt đỏ trở thành động cơ tăng trưởng siêu tốc và bền vững.